Структура лекций
Каждый пункт — отдельная лекция:
- Вводная (эта).
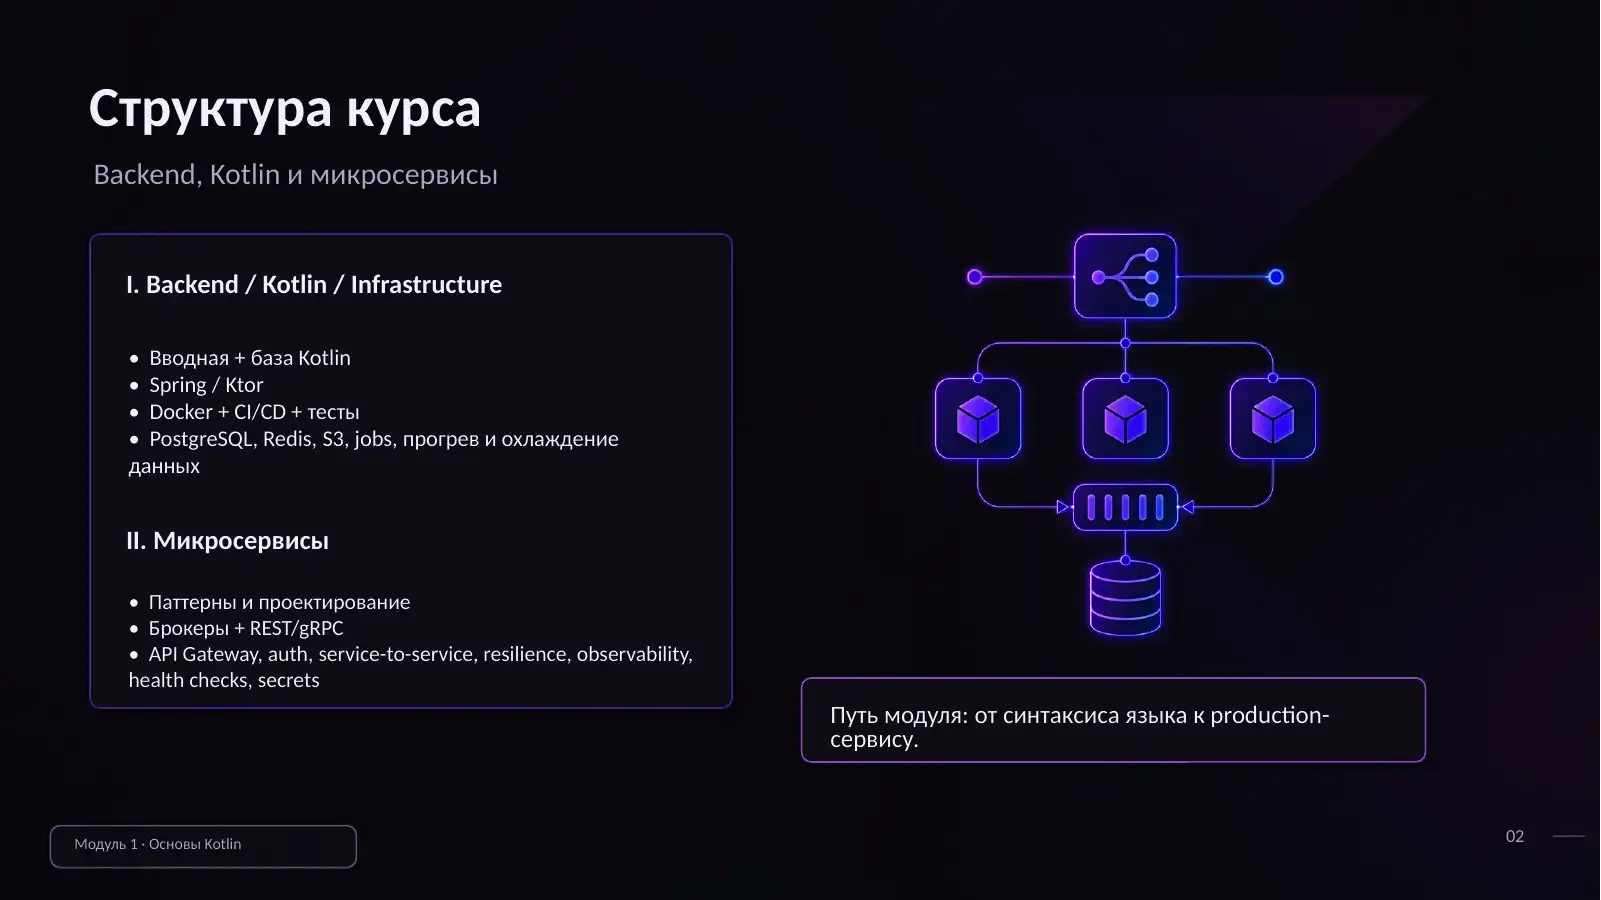
- Фреймворки — Spring Boot и Ktor. На Kotlin можно писать как обычно, без фреймворка, можно со Spring Boot, можно с Ktor.
- База: Docker, CI/CD, тесты — инфраструктура, которая понадобится, потому что репозиторий и CI/CD студенты создают и пишут сами. Катя очень привередлива к коду, так что она задаст «гигантский линтер» — удачи написать так, чтобы он прошёл.
- Работа с данными — больше про продуктовую часть. Отдельно разберут прогрев данных: зачем это нужно и почему так делается.
- Микросервисы — три лекции, средне-поверхностно. Там особо много рассказывать и не нужно.
- Многопоточность — сначала что такое многопоточность, чем она отличается от асинхронности и от синхронности (на вопрос «кто знает, что такое асинхронность?» зал промолчал, поэтому по этому пройдутся отдельно), потом — как к асинхронности и многопоточности подходит сам Kotlin.
На этом заканчивается первый блок курса: в нём пишется бэкенд-сервис с микросервисной архитектурой, асинхронный.
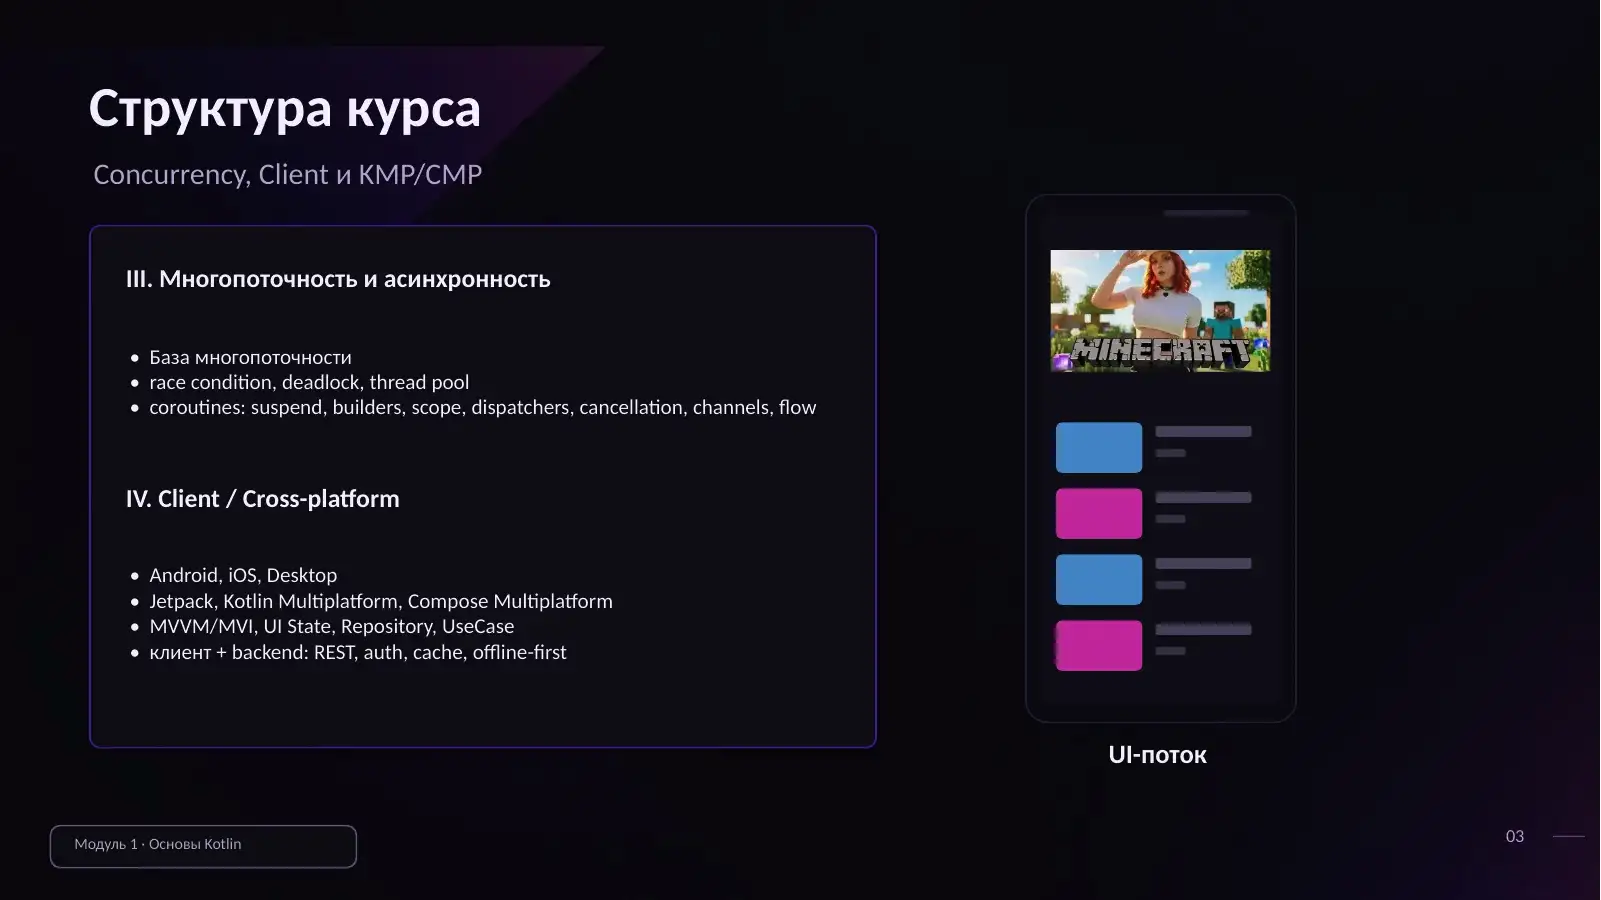
Дальше идёт второй, более маленький блок — четыре-пять лекций, может и сократиться. В нём пишется кроссплатформенный клиент.
Mac и кроссплатформа
Чтобы писать приложение под iOS — да и вообще любое приложение под iOS — обязательно нужен Mac, «Apple такая классная компания». Отсюда деление:
- есть Mac → кроссплатформа iOS + Android;
- нет Mac → кроссплатформа Android + Desktop.
Достаточно просто Mac, iPhone не требуется.
Проект и оценивание
Репозиторий
Организации на курсе не будет («мне падло создать организацию»), поэтому каждый создаёт свой публичный репозиторий на личном аккаунте — он так и останется вашим проектом. Совет: сразу заложить две части, server и client. Можно сделать многомодульный проект, можно и свою организацию — как душе угодно. Ссылка на репозиторий кидается в общую табличку, которую создадут после лекции.
CI/CD пишется самостоятельно. Линтер лекторы придумают сами — это личное желание Кати, вопросы про него можно задать ей на следующей лекции.
Сборка — только Gradle, причём Gradle на Kotlin DSL: за Groovy-синтаксис обещан insta-ноль, причина — «личное предпочтение» и личная неприязнь. Более того, в линтер будет добавлена строчка, из-за которой Groovy-стиль его просто не пройдёт.
Версию Kotlin можно брать любую, хоть самую свежую — релиз был буквально пару дней назад.
Всё должно быть развёрнуто в Docker. Развёрнуто не в Docker — минус 5 баллов, и в каждой лабе.
Лабы и баллы
Балльной системы на курсе нет. Лаб будет примерно 3–4 на бэкенд и 2 на клиент (одна — логика на KMP, другая — UI на CMP), то есть всего порядка шести-семи. Лекторам самим приятнее, когда лаб меньше — меньше проверять.
Экзамен необязательный: закрыться на 5 без экзамена можно, но для этого нужно сделать все доптаски — в каждой лабе будет свой. Сделать одну и рассчитывать на пятёрку не получится.
Дедлайны, ревью и защита
Дедлайны обещают довольно обширные. Схема работы: написали лабу, залили, встали в очередь в табличке со ссылкой на репозиторий — получаете ревью один раз. Всё найденное можно исправить до защиты, и тогда на защите проблем не будет. Ревью будут стараться делать быстро, но лекторов двое на ~40 человек.
Защита очная: код смотрят вместе с вами и показывают, где «какашка» и почему так делать нельзя. Если плохое место находится уже в процессе защиты, скорее всего дадут минут 10–15, чтобы найти и исправить — лектору «в целом пофиг», можно всё отходить.
Деления на подгруппы на практике не будет: принимают все вместе, синхронно смотрят пулл-реквесты и по табличке идут по списку — кто свободен, тот и берёт.
Первая лаба
Первая лаба — это, по сути, старт:
- выбрать тему;
- создать и настроить проект, подтянуть зависимости;
- настроить CI/CD (пока без линтера — его ещё не написали);
- немного потыкаться в Docker;
- описать, как планируется разбить проект на микросервисы (какие будут) и как примерно видится UI.
Тема открытая, но нельзя брать ту же, что на вебе — иначе можно написать один бэкенд и закрыть следующий семестр. Микросервисировать при этом можно буквально любой проект: на предложение «делаю банкомат» последовал вопрос, как именно будут печататься купюры — через маленький принтер от Xiaomi?
Смысл курса — чтобы на выходе был один целиком готовый отдельный проект: серверсайд и клиентская часть. И чтобы попутно разобраться с базовыми вещами вроде Docker и CI/CD с тестами: попросить нейронку написать CI/CD можно, но она напишет «какую-нибудь фигню», которую вы не сможете прочитать. С тестами у нейронки получается лучше, но их всё равно разберут отдельно — а глубоко в тестирование можно будет уйти на четвёртом курсе, на курсе тестирования.
Идея с собесом вместо экзамена
Если группа будет супер активной, есть идея вытащить на экзамен HR — и тогда вместо экзамена будет собес с командой: дадут таску, её нужно будет решать и рассказывать, больше про язык. LeetCode на таком собесе не будет. Чтобы попали не все, придумают какую-нибудь систему отбора — сдал все лабы, все задания, что-нибудь ещё. Стоит держать в голове, что собес с командой и HR-собес — это разные этапы целиком.
Презентация
Презентация сделана так: ChatGPT хорошо сгенерировал аватарку для чата, понравился стиль — дальше в него же попросили сложить всю инфу по слайдам. От человека в ней остались правки цифр на некоторых слайдах. Это, скорее всего, единственная презентация за весь курс — дальше будут примеры кода.
Kotlin
Почему приятнее Java
Два главных пункта:
- Меньше boilerplate. Геттеры и сеттеры писать не нужно вообще.
- Null-safety из коробки. В Java, чтобы честно передавать null, приходится заворачиваться в
Optional; в Kotlin nullability встроена в систему типов и обрабатывается очень хорошо.
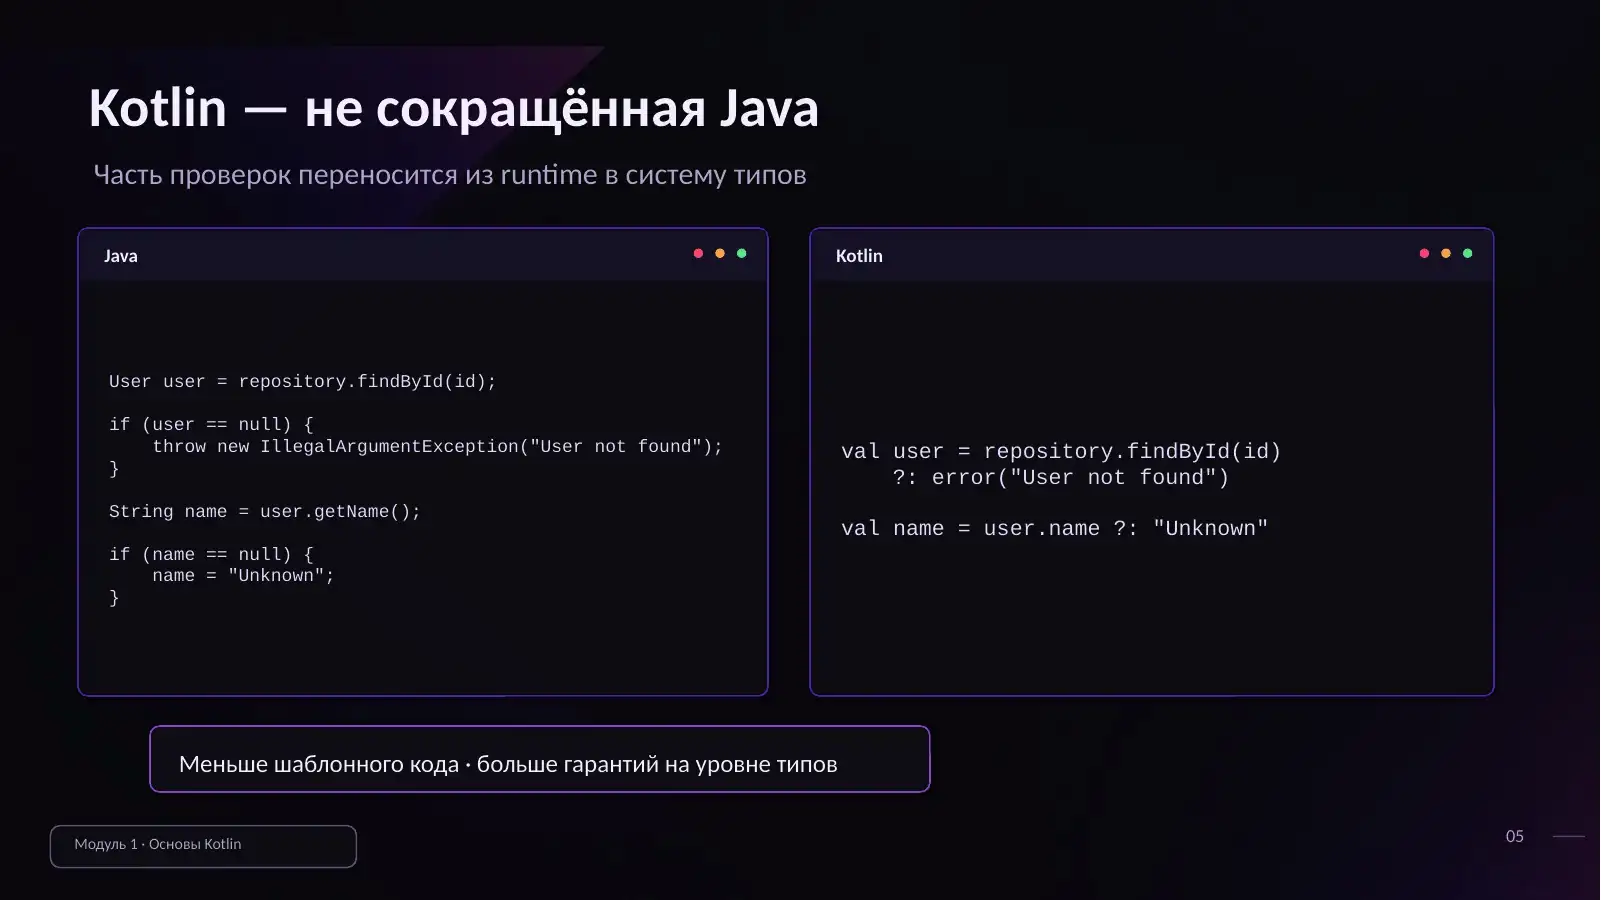
Небольшие проблемы у этого тоже есть, и все они растут из обратной совместимости с Java.
Типы и вывод типов
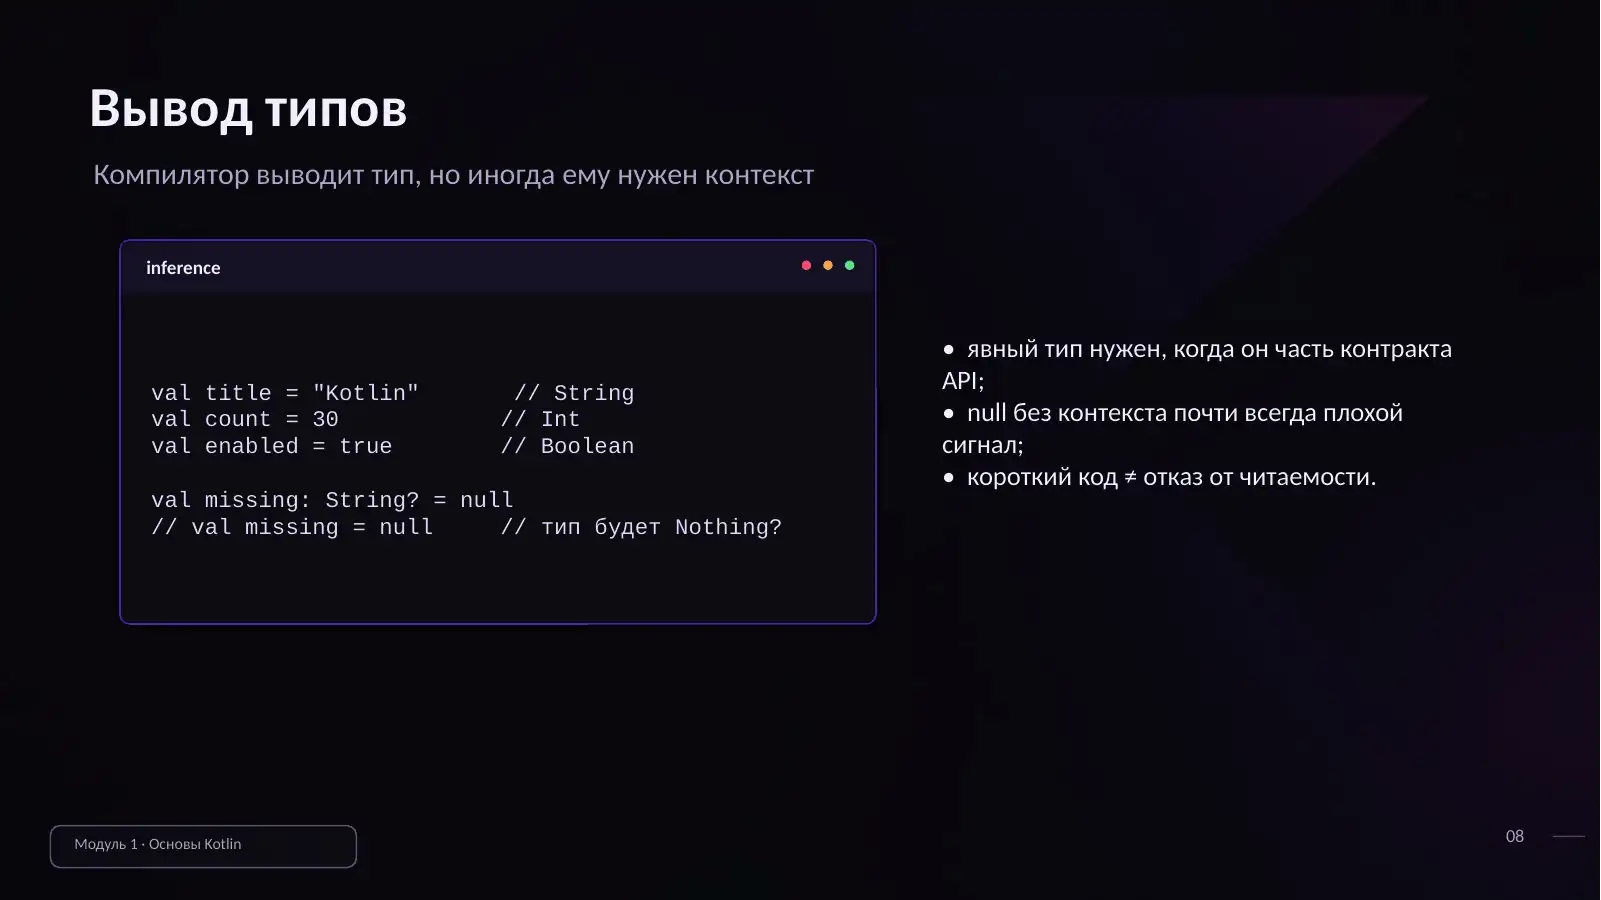
Писать типы данных не принято: они есть (Int, String), но компилятор умный и подставит их за вас.
Тип через двоеточие нужен только тогда, когда переменную вы инициализируете позже:
val a = 5        // тип писать не нужно
val b: Int       // присвоим позже — тип обязателен
Без явного типа компилятор просто не поймёт, что это за переменная. Дженерики при этом стираются так же, как в Java — на вывод типа в отложенном присваивании рассчитывать нельзя.
val и var
val — значение, которое можно присвоить один раз и нельзя переприсваивать. var — обычная переменная, меняется спокойно.
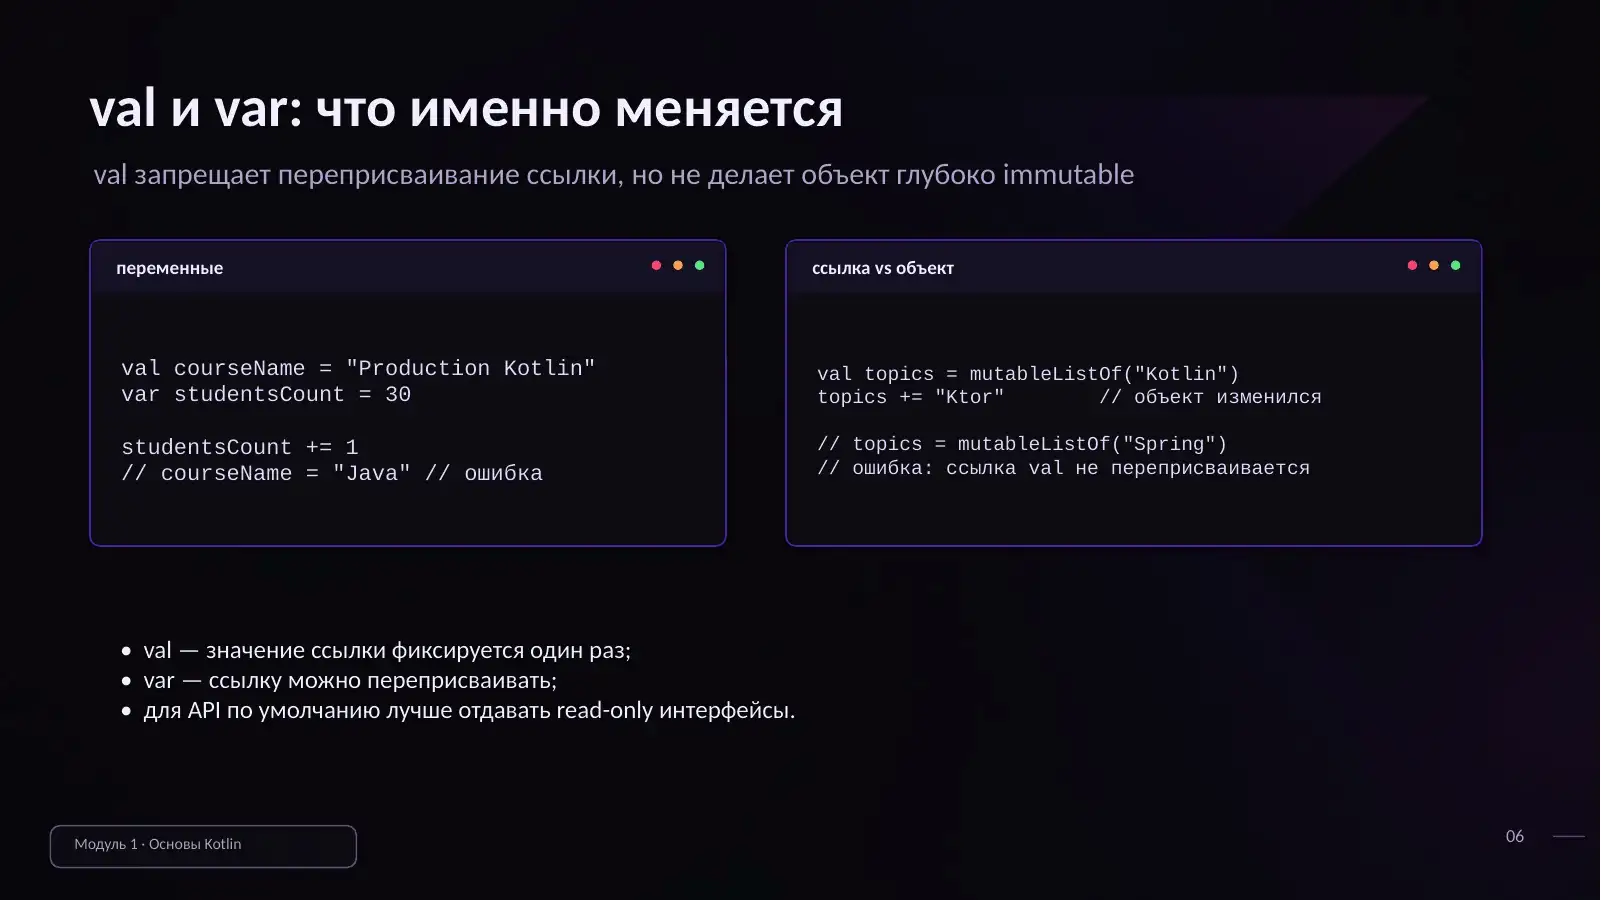
Нюанс: если в val лежит MutableList или любая другая mutable-сущность, её состояние менять можно — неизменяемость тут только у ссылки.
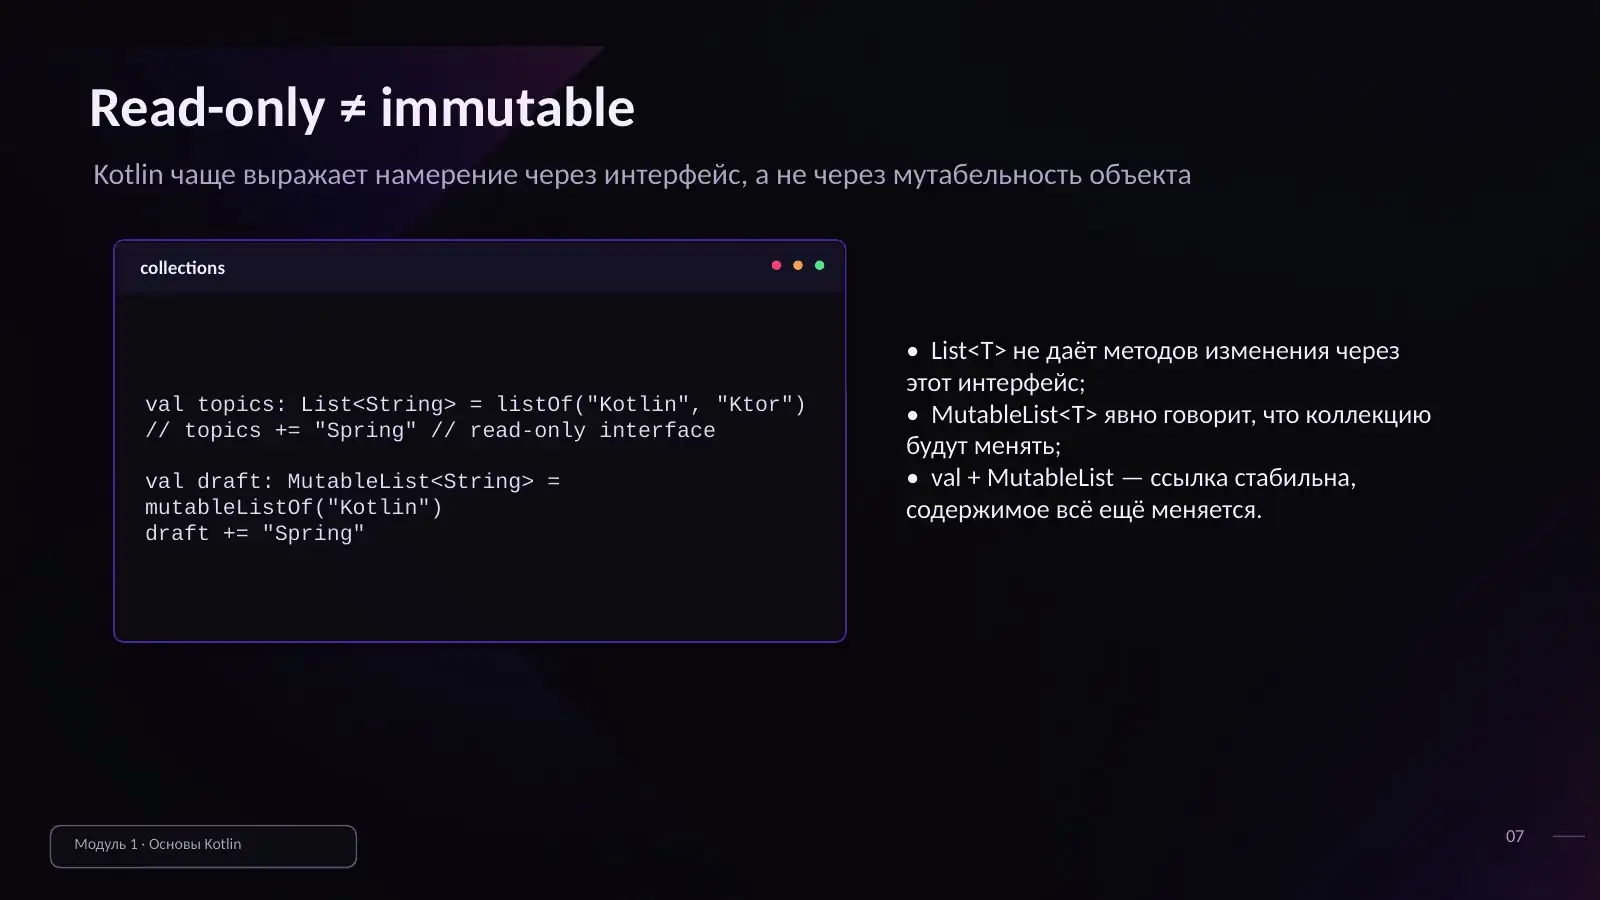
Как писать правильно: сначала всегда val. Если идея подчеркнёт, что без var не скомпилируется, тогда меняете. Так принято делать всегда: чем меньше mutable-переменных, тем меньше шансов на ошибку в рантайме, а mutable как раз этот шанс даёт.
Mutable-типы данных в Kotlin вообще не особо приняты. Если нужно сохранить состояние — не мутируете вход, а создаёте новый data-класс: берёте тот, что пришёл на вход, добавляете нужные поля и возвращаете другой data-класс с изменёнными значениями.
var для коллекций тоже имеет смысл, но редко: только если вам нужно переприсвоить саму коллекцию целиком, а не добавлять и удалять элементы.
Геттеры и сеттеры
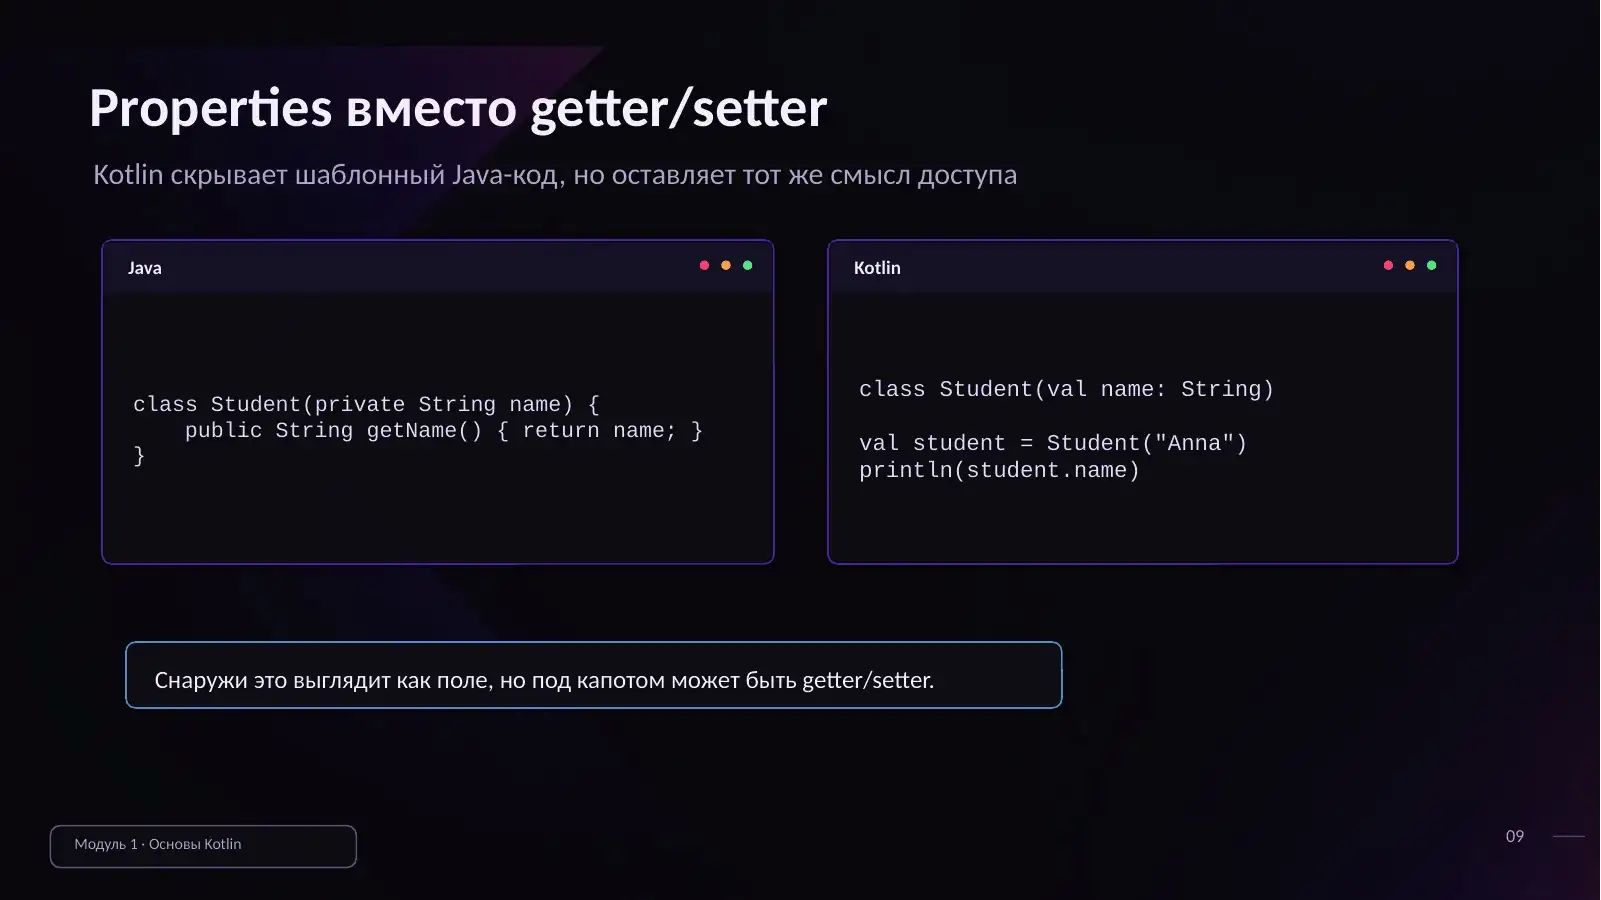
Их не пишут. Обращение к полю само вызывает геттер или сеттер.
Аргументы функций
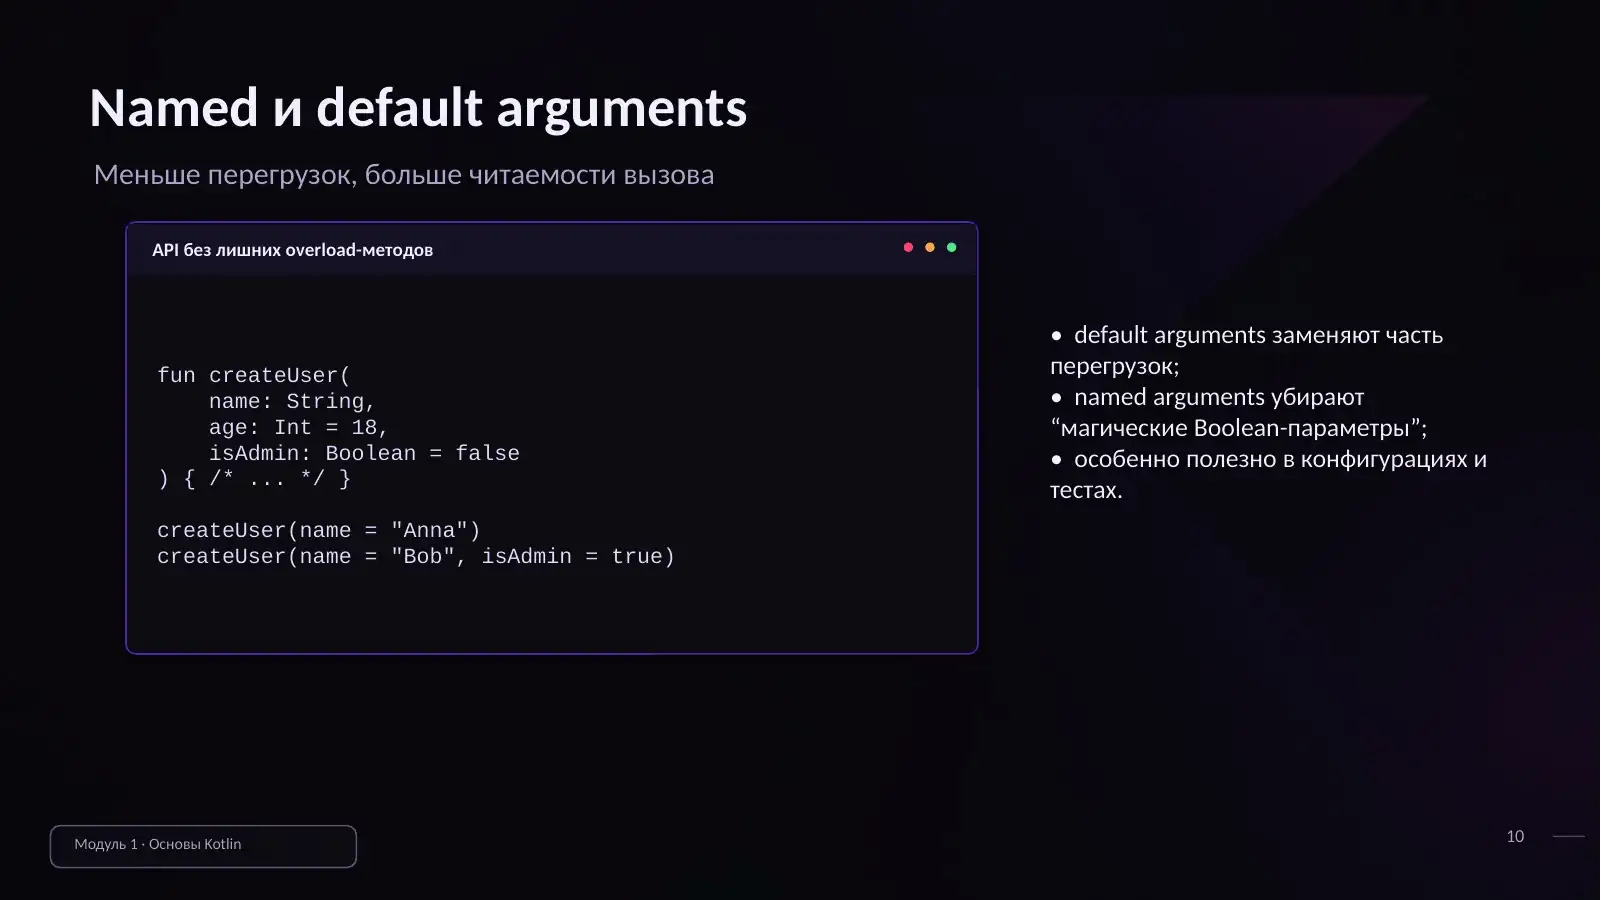
Две вещи, которых нет в Java (и которые есть, например, в Python):
- дефолтные аргументы — их можно задать прямо в объявлении функции;
- именованные аргументы — передавать можно в любом порядке, если указать имена. По порядку тоже можно, никто не запрещает.
Null-safety
Главное преимущество перед Java. Вопросик после типа означает, что переменная может быть null:
val name: String? = ...
val result = name?.trim() ?: "Anonymous"
?.— любой вызов у nullable-типа подразумевает проверку на null. Еслиnameдействительно null,trim()и все последующие операции просто не выполнятся.?:— Elvis-оператор, fallback на случай null. Еслиnamenull, цепочка обрывается и выполняется то, что справа — тут вернётся"Anonymous".
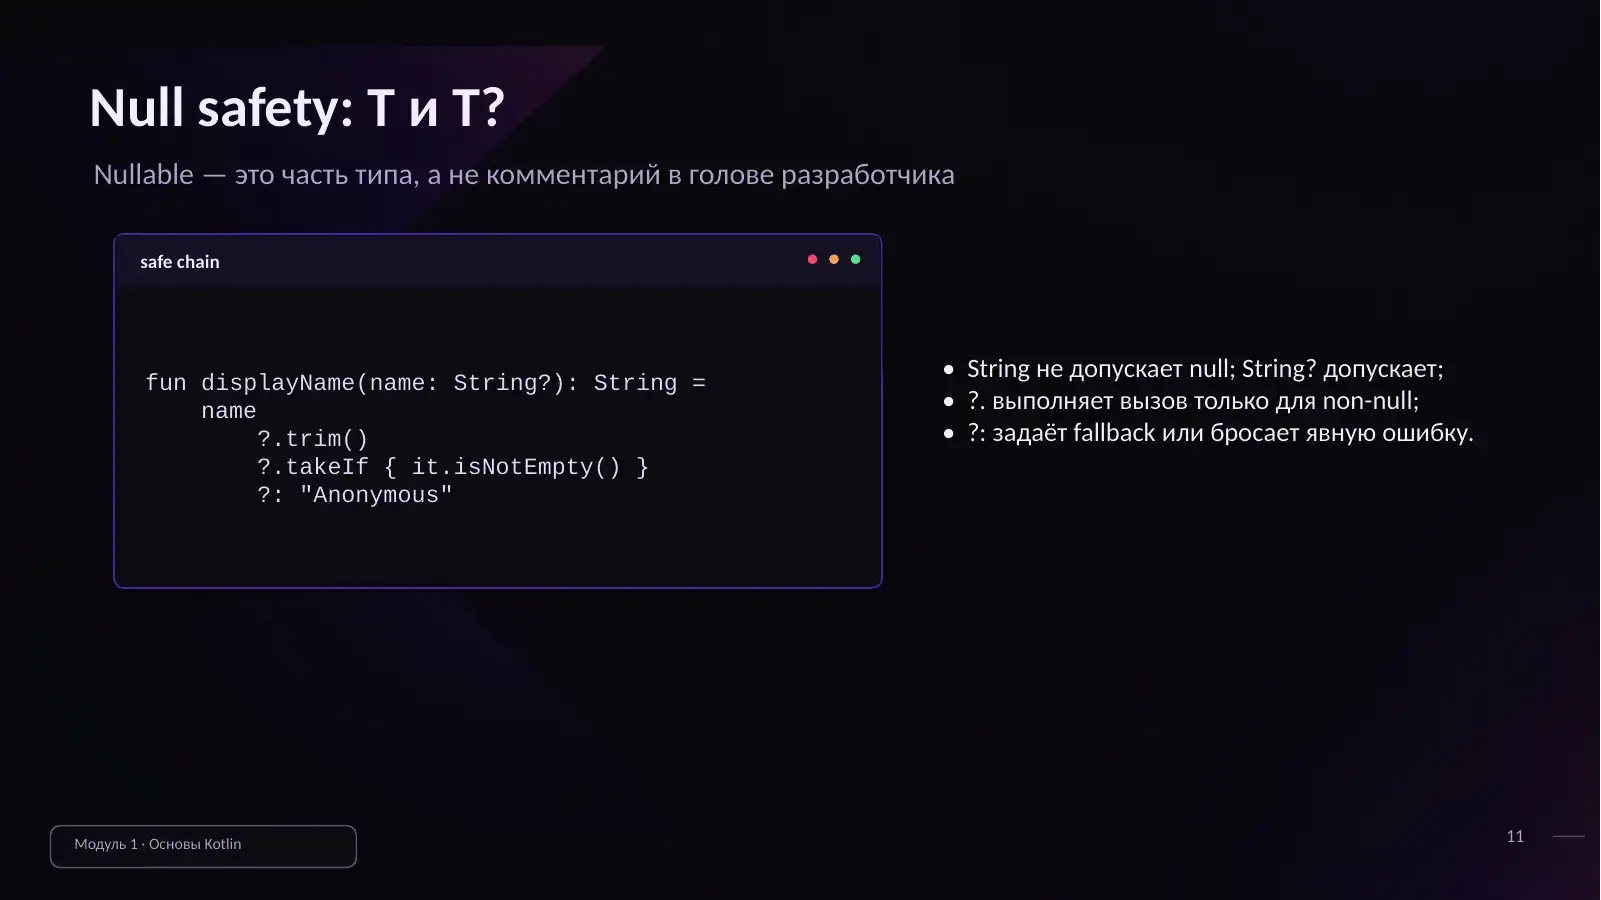
Частый вопрос: зачем писать ?. перед каждым вызовом, если первый уже проверил на null? Потому что каждый вызов — отдельная конструкция, и предыдущий вызов может сам вернуть nullable. trim() вернёт переменную, и вы не знаете, null она или нет; а есть, например, takeIf, который вполне может вернуть null и заставить проверять следующий шаг. Замапить можно и так, что получится полная грязь — но писать так очень плохо.
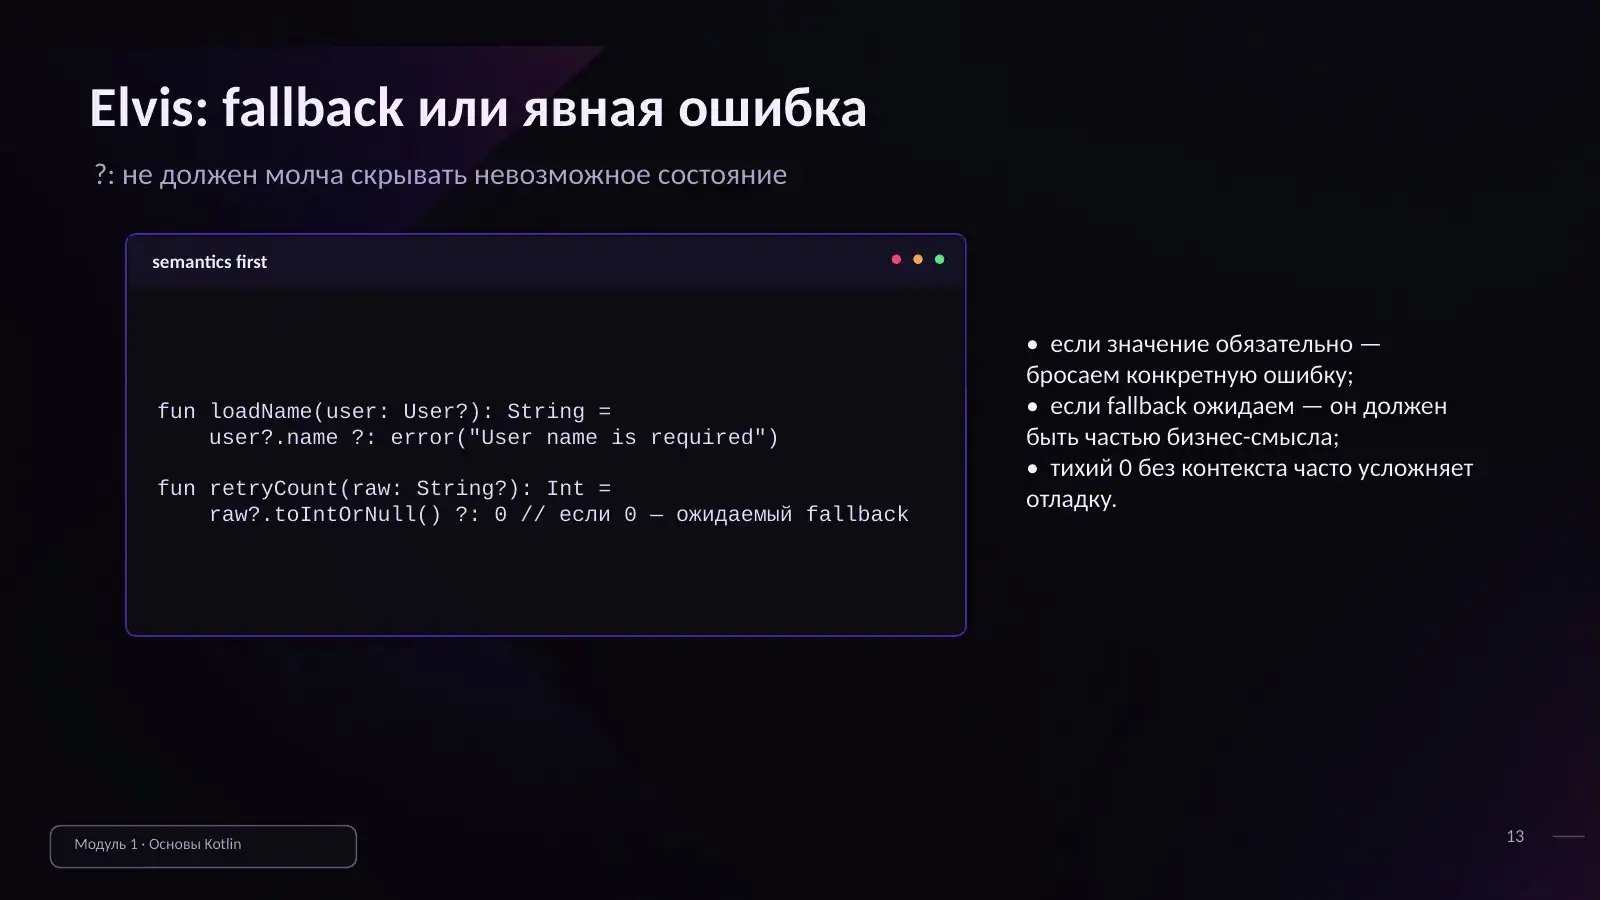
Elvis желательно делать ошибкой: принято, чтобы в fallback-ветке бросалось исключение.
!!
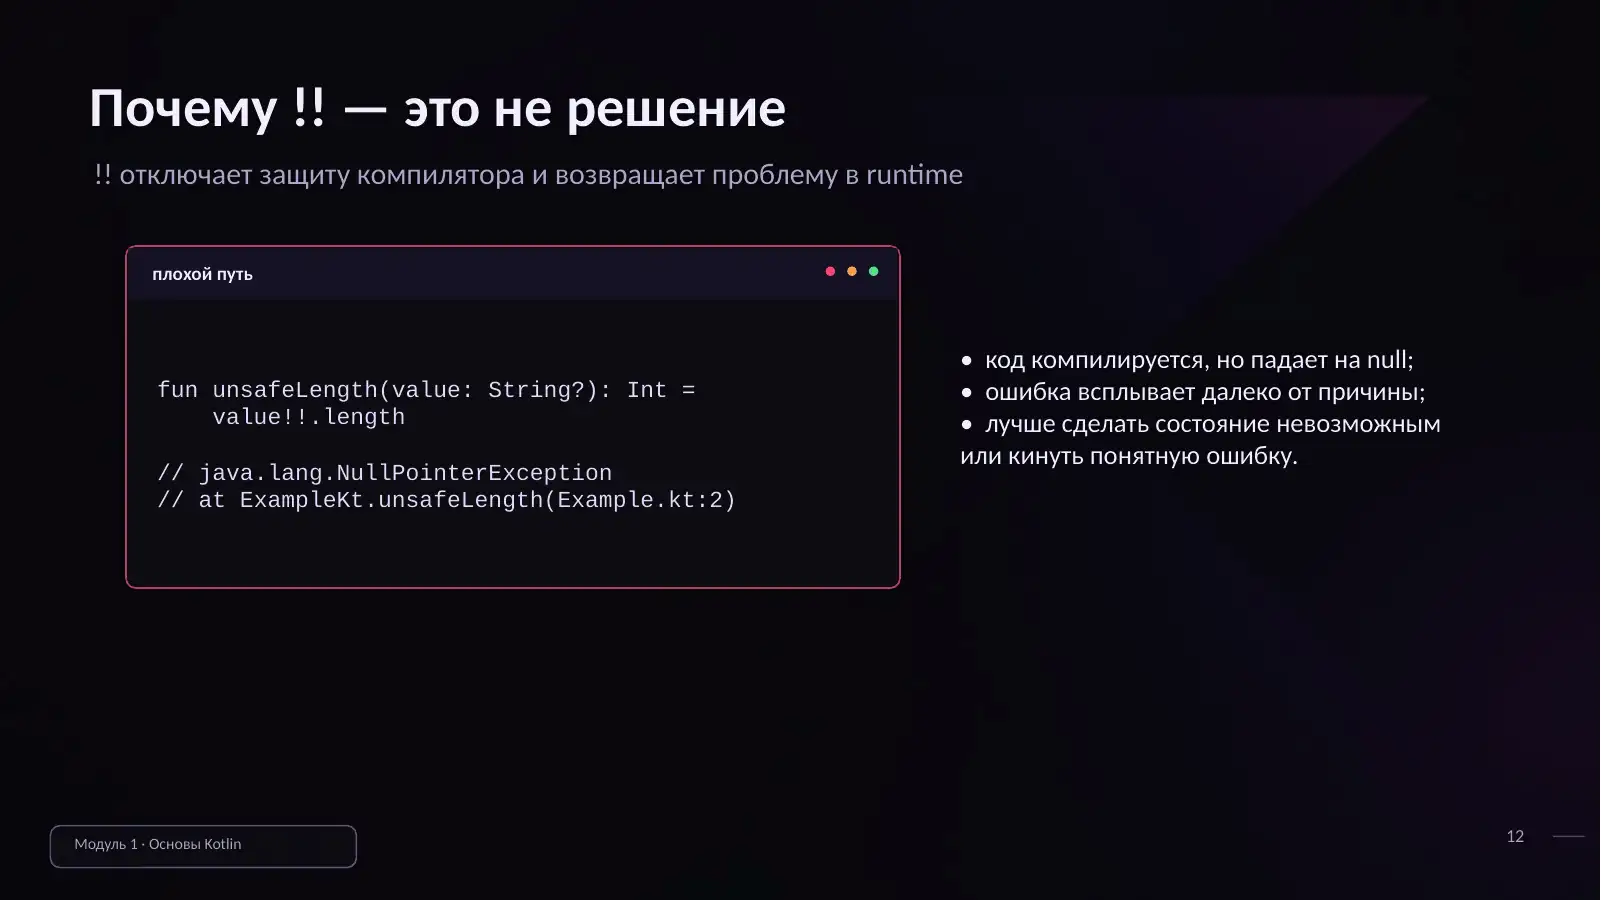
Два восклицательных знака — это сообщение компилятору: «я знаю лучше тебя, подавляй проверку на null». В логике так не стоит делать вообще никогда. Единственное место, где это оправдано, — тесты. Ну либо если вы хотите получить NullPointerException.
Касты
Каста как такового в примере нет — есть проверка на тип: является ли значение строкой. Дальше два варианта:
val s = value as? String   // безопасно: вернёт null
val s = value as String    // опасно: взорвётся в рантайме
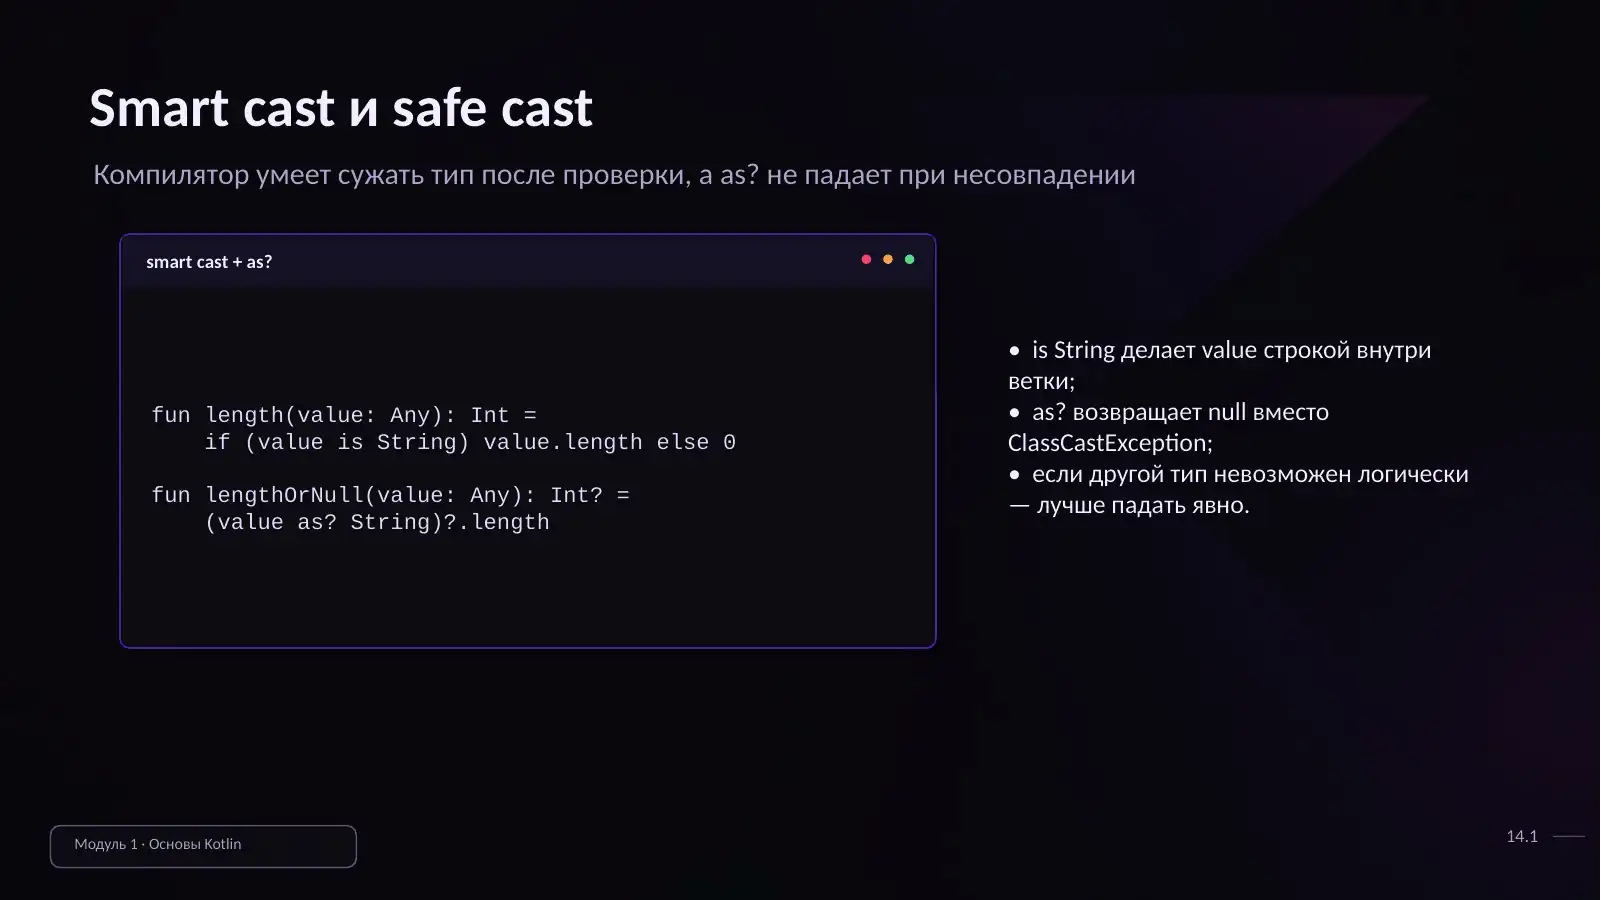
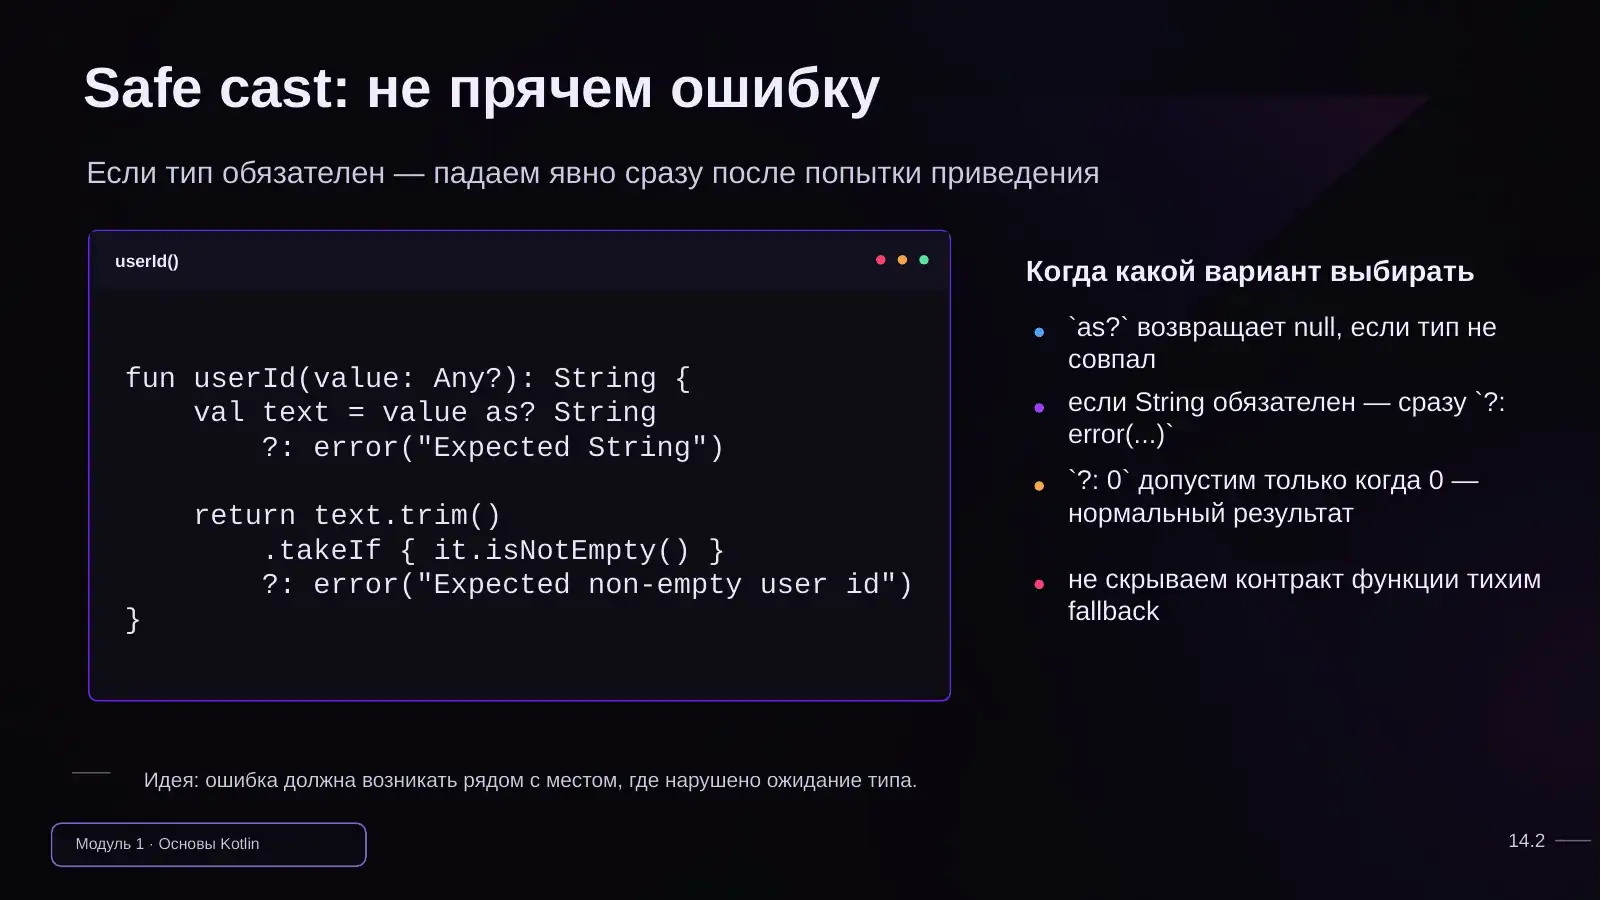
Прямой каст без вопросика кинет ошибку, ровно как в Java. С as? рантайм не упадёт, но результат нужно проверить — и принято сразу же на месте вернуть ошибку через Elvis. Если писать так, до ловли конкретного типа исключения дело почти никогда не доходит.
Any
Как и в Java, все классы наследуются от общего корня — здесь это Any. От Java-Object он отличается тем, что функций у него меньше и мусора, соответственно, тоже: hashCode, toString, copy, equals и componentN. componentN — обращение к N-му полю: если в классе пять полей, component2 — это второе.
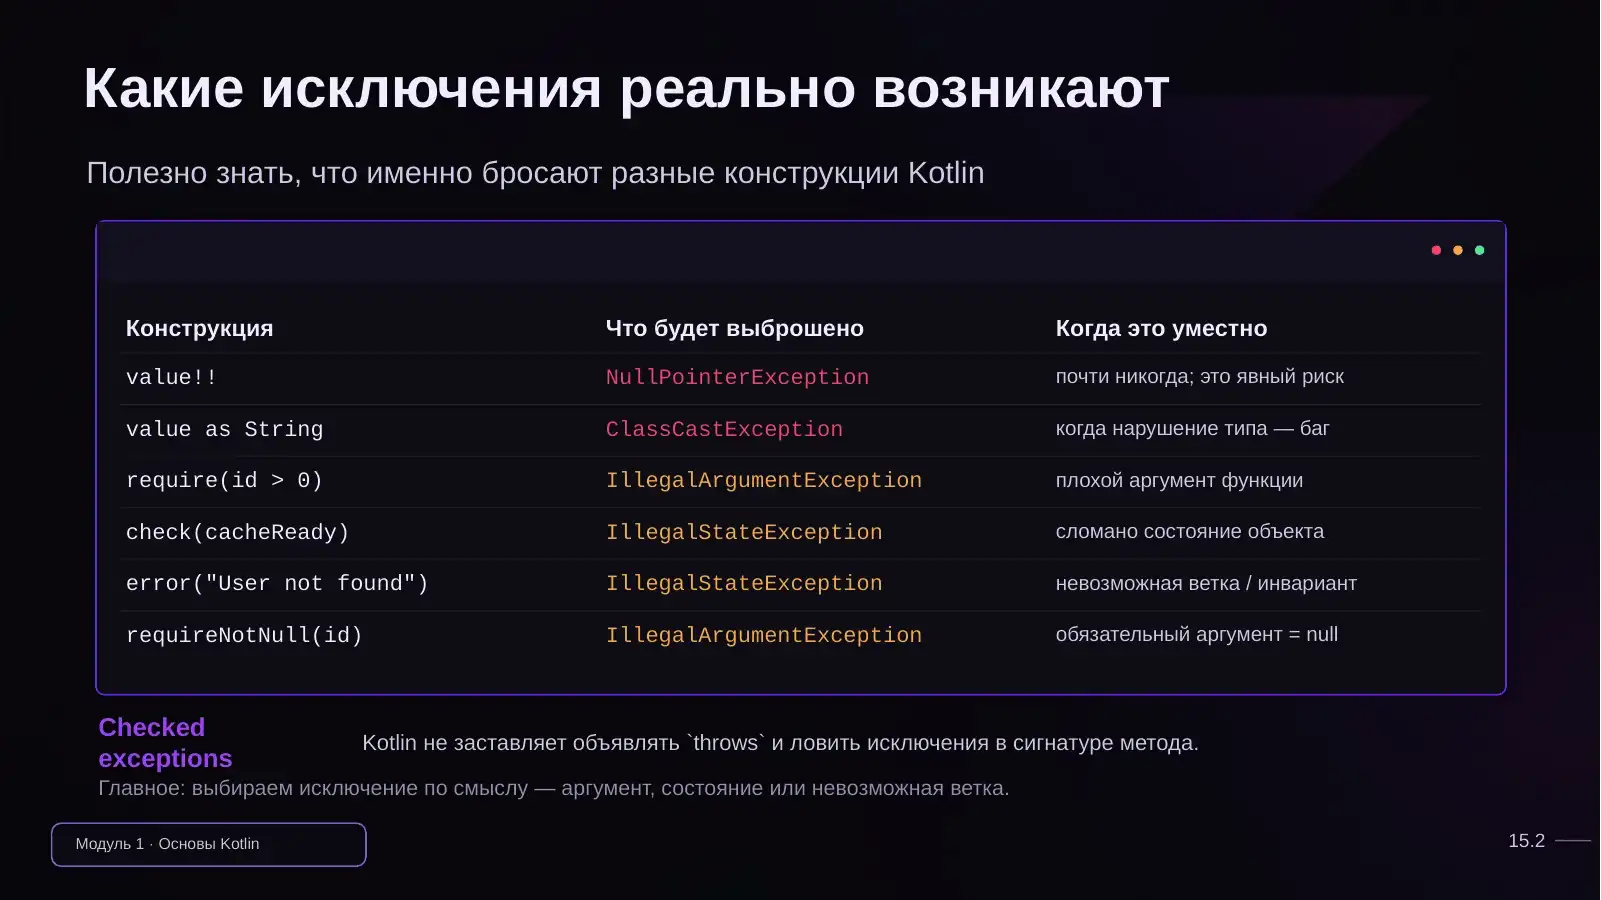
error, check, require
Три семантически разные функции. Их плюс в том, что error не нужно писать в throw — Kotlin сам понимает, что произошло и какое исключение вернуть. Два из них кидают одно и то же исключение, третья — другое: отличается require, потому что это проверка аргумента, того, правильный ли аргумент пришёл.
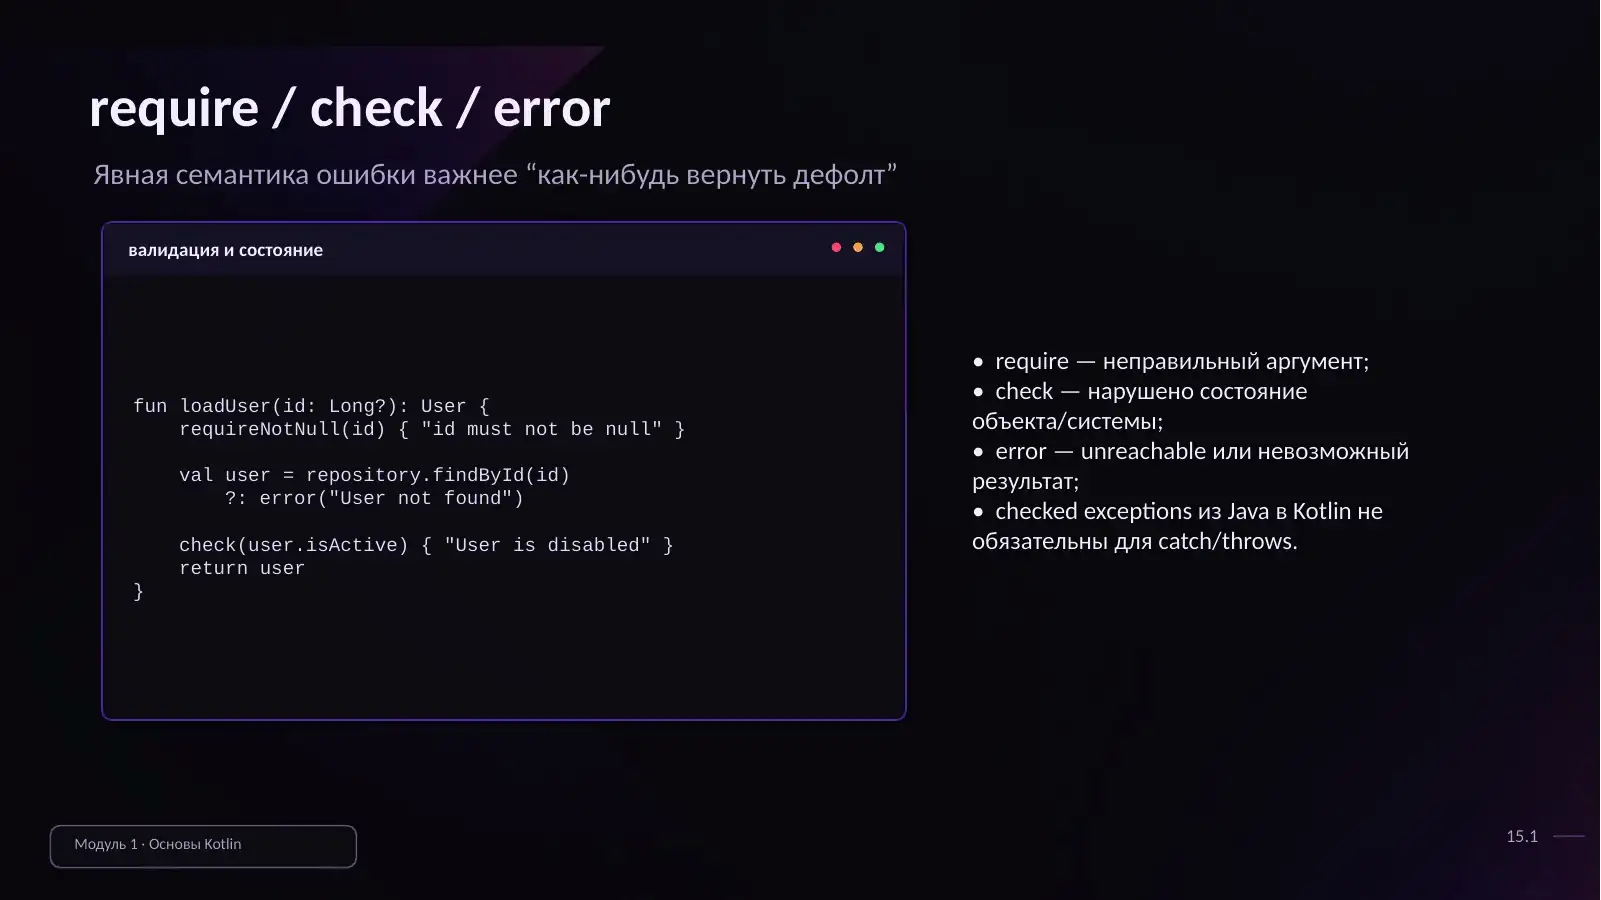
По-хорошему это просто семантика, которая упрощает чтение кода другими разработчиками; в основном используется error. Если вы нормально пишете код и делаете null-проверки, ловить конкретный тип исключения не придётся вовсе.
Платформенные типы из Java
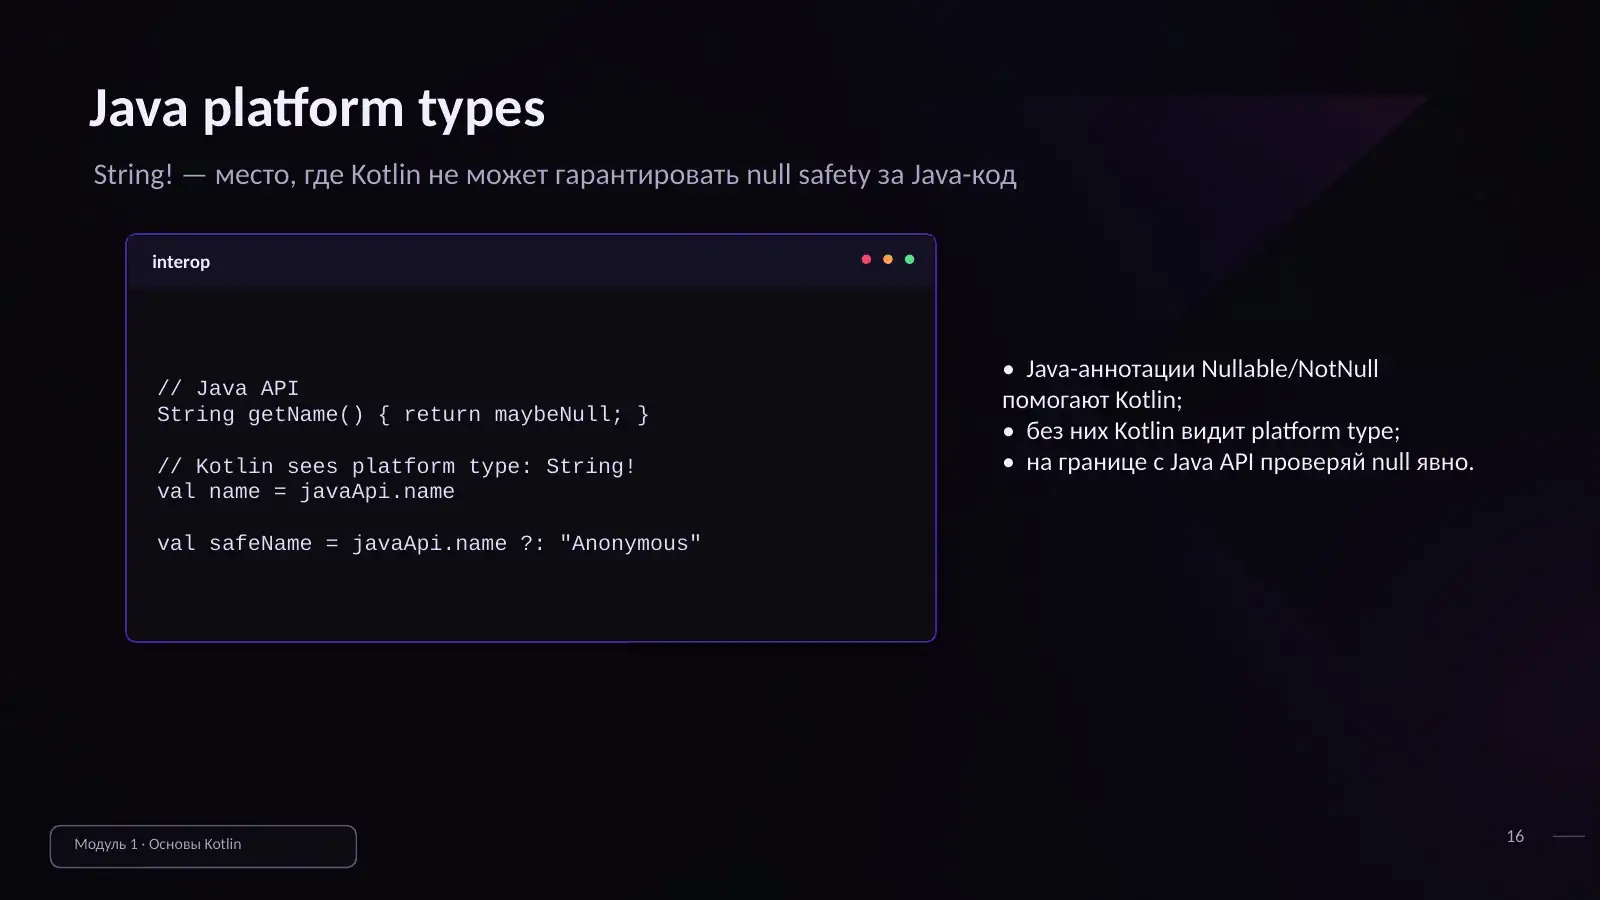
Тот случай, когда обратная совместимость мешает. Java-String при импорте приходит без нормальной разметки nullability, поэтому Kotlin воспринимает её как String! — платформенный тип. Нормально обработать null за вас он не сможет, придётся размечать самому.
Если же Java-библиотека размечена аннотациями nullability целиком и хорошо, Kotlin всё сделает за вас идеально и делать ничего не нужно.
Ktor и Spring
Spring — очень объёмный фреймворк, прямо очень. Ktor — более легковесная штука, больше про HTTP-запросы и более легкий подъём сервера. Разница ощутимая: приложение на Ktor собиралось около 50 секунд, на Spring — около 150. И чем больше модулей Spring вы подключаете, тем проблемнее. Подробное сравнение — на следующей лекции.
when, if, else как выражения
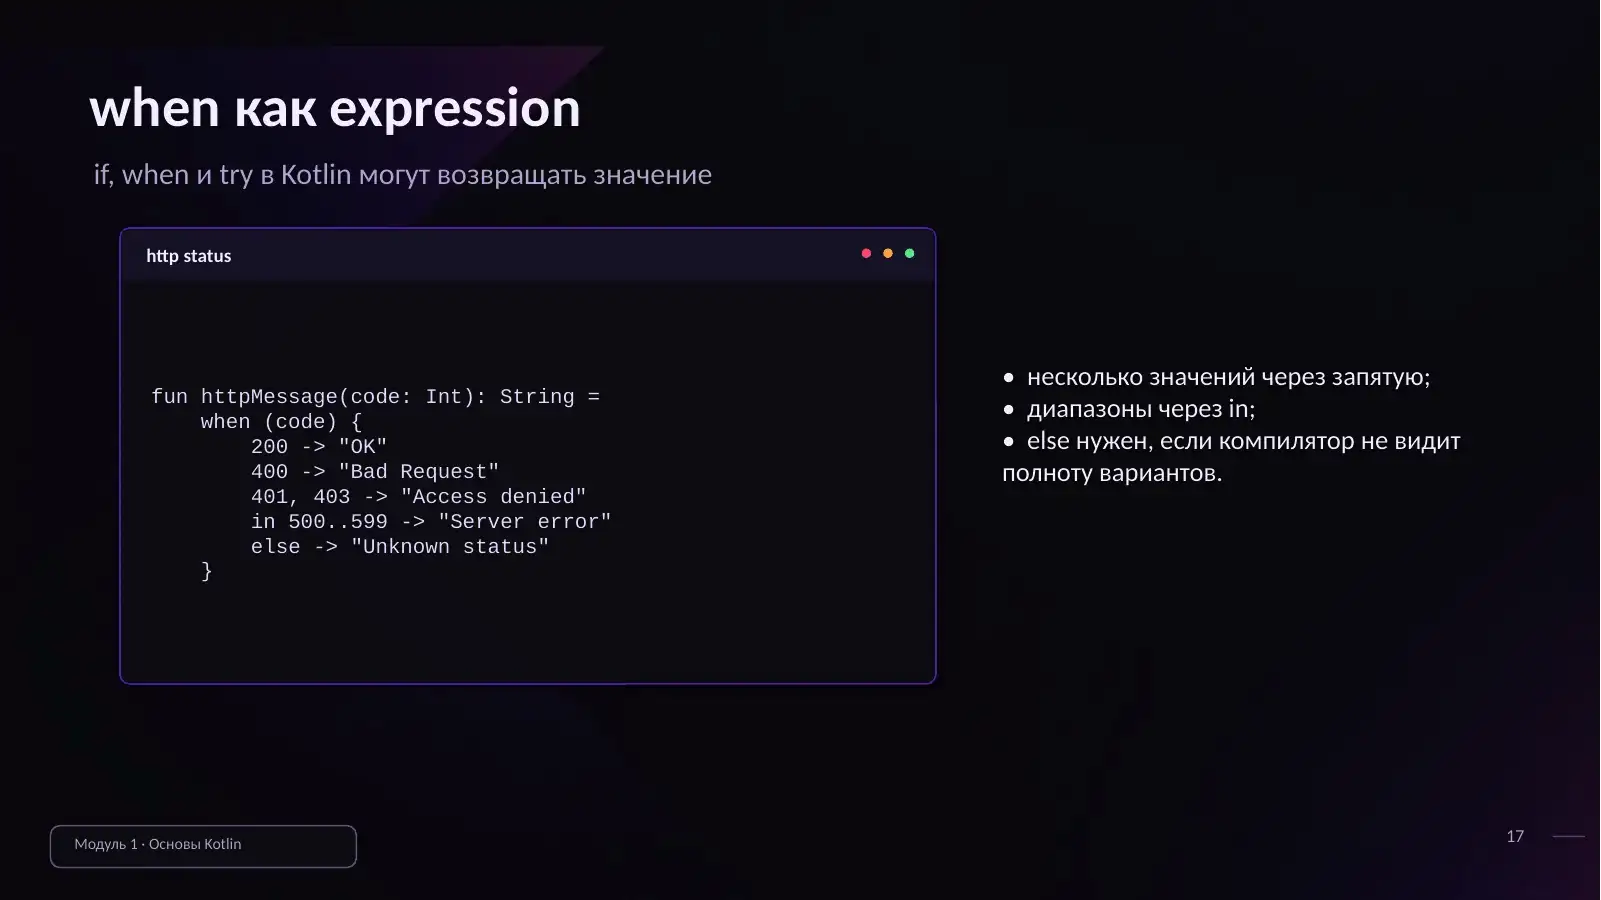
if, else и when в Kotlin возвращают значения — переменную заводить не нужно, можно сразу вернуть результат.
when — это switch-case «из плюсов». Можно задавать несколько значений через запятую и целые диапазоны:
when (code) {
    in 500..599 -> ...
}
Циклы и диапазоны
Классического for (i = 0; i < n; i++) в Kotlin не существует: все циклы итерируются по объектам. Поэтому вместо него:
for (i in 500..599) { ... }
500..599 реально создаёт коллекцию от 500 до 599. Шаг задаётся через step, синтаксис самого цикла при этом не меняется — меняется только задание range. Работает быстро; на вопрос «а если от 1 до 10 миллионов?» ответ был короткий: ну, делай.
Грустная правда из практики: for-range почти никто не использует. Опрошенные разработчики отвечали одинаково — в Kotlin они его никогда не писали. За полтора года на Kotlin он писался только при изучении языка, чисто по приколу, и ни разу на работе.
Можно ли комбинировать диапазоны — хороший вопрос, который не тестировали. Скорее всего просто соединит две коллекции в одну, но чтобы это сработало, тип, видимо, придётся указать явно.
sealed классы
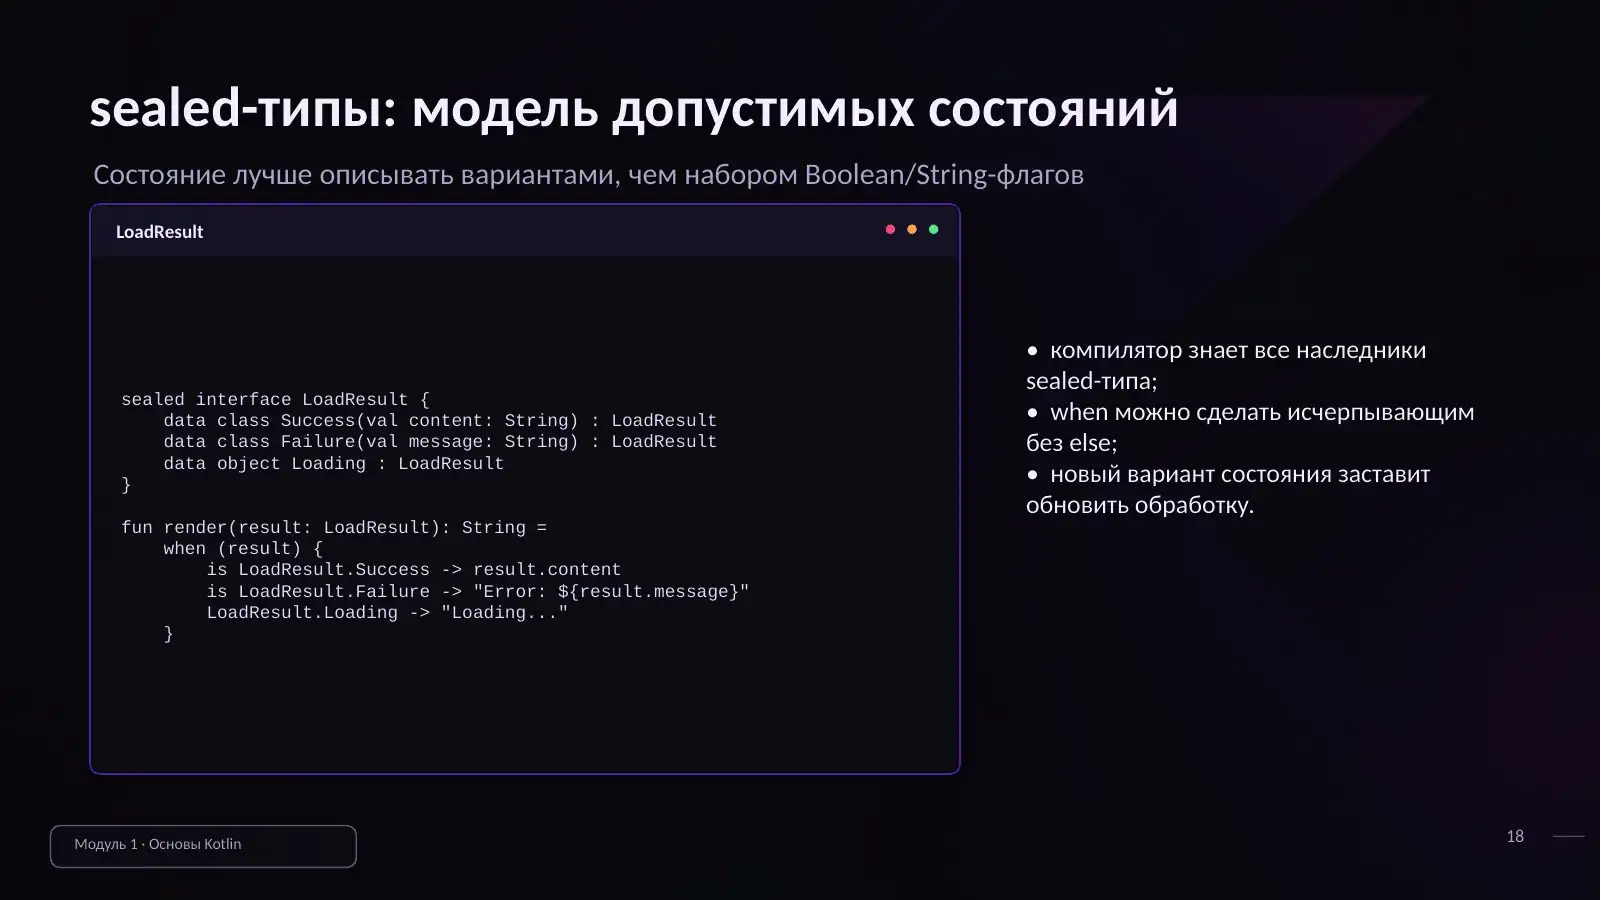
Это те самые алгебраические типы данных, которые должны вызвать ПТСР у всех, кто был на паре у Гоши Круглова. В Kotlin они сделаны через sealed-класс (в C# ключевое слово тоже sealed). Очень удобно с when: подставляете и всё работает с кайфом.
data class
Самая лучшая вещь в Kotlin. Это просто data holder, который сам создаёт все нужные методы: equals, hashCode, copy, toString, компоненты — за вас, без всяких аннотаций как в Lombok со всеми его прелестями.
Скорее всего именно через data-классы вы будете прокидывать результаты, общаться между функциями и передавать данные. Маппер для такой штуки пишется очень легко: получили данные из базы — и спокойно маппите их между сервисами туда-сюда.
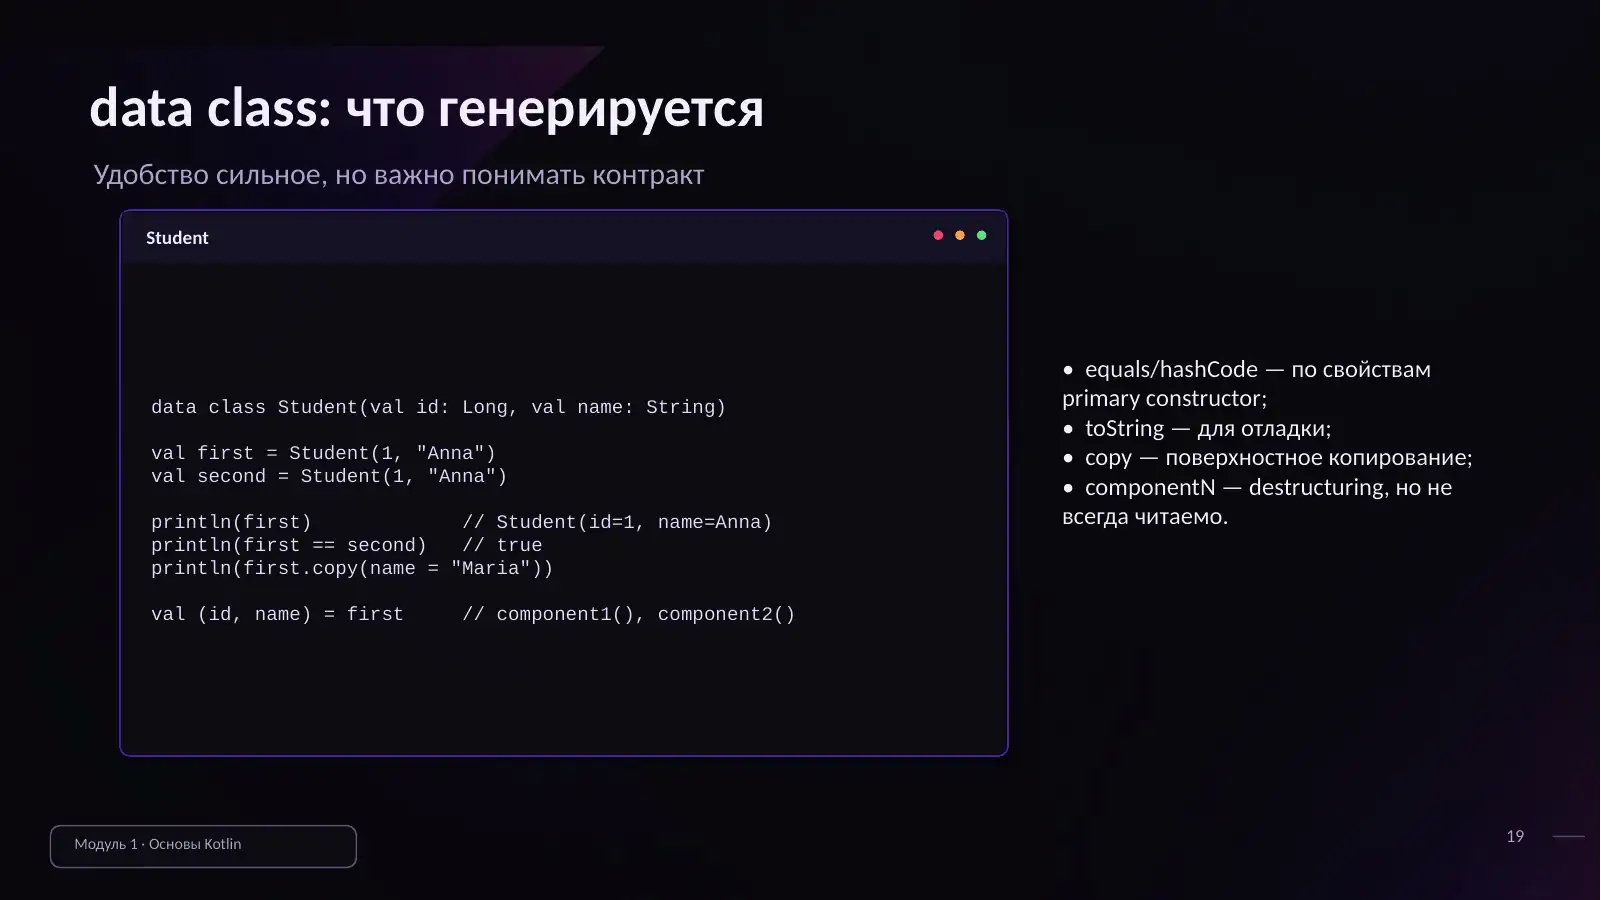
Базовая проблема та же, что в Java: если внутри data-класса лежит mutable-тип, ломается hashCode. Mutable-лист логично может менять своё состояние, при изменении меняются внутренние сущности, а значит и хеш-код самого data-класса. Обратитесь к старому хешу — такого больше не существует. Поэтому mutable-штуки внутри не храним, как и везде.
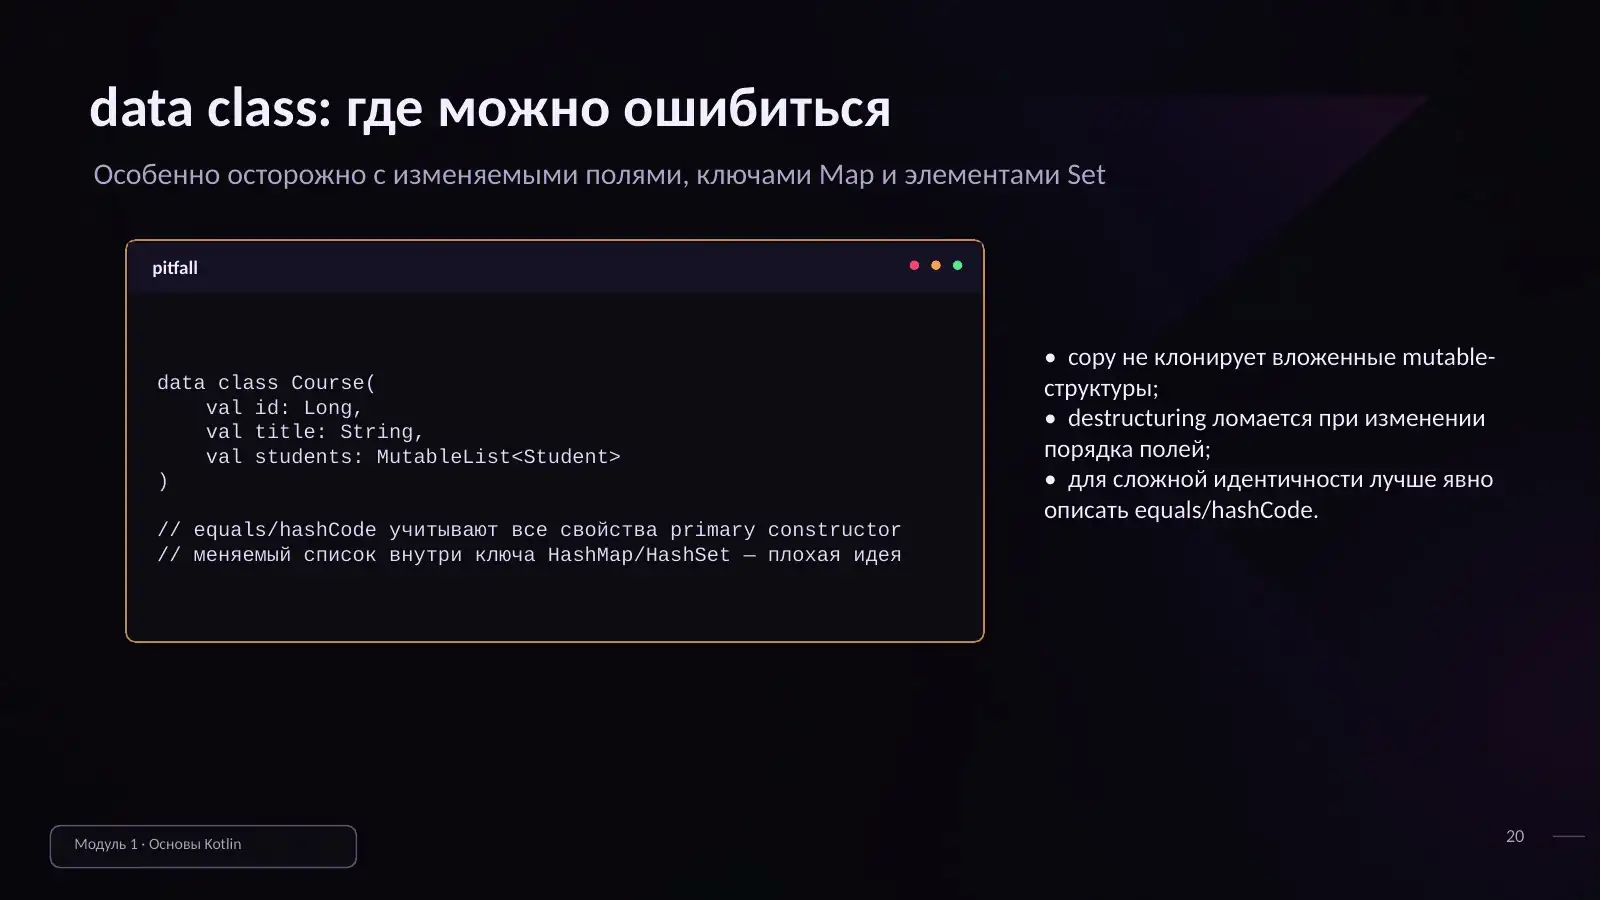
Сравнение с Java-record: data-класс — это «более обширный record».
== и ===
В Kotlin два типа сравнения, и здесь исправлена небольшая проблема Java:
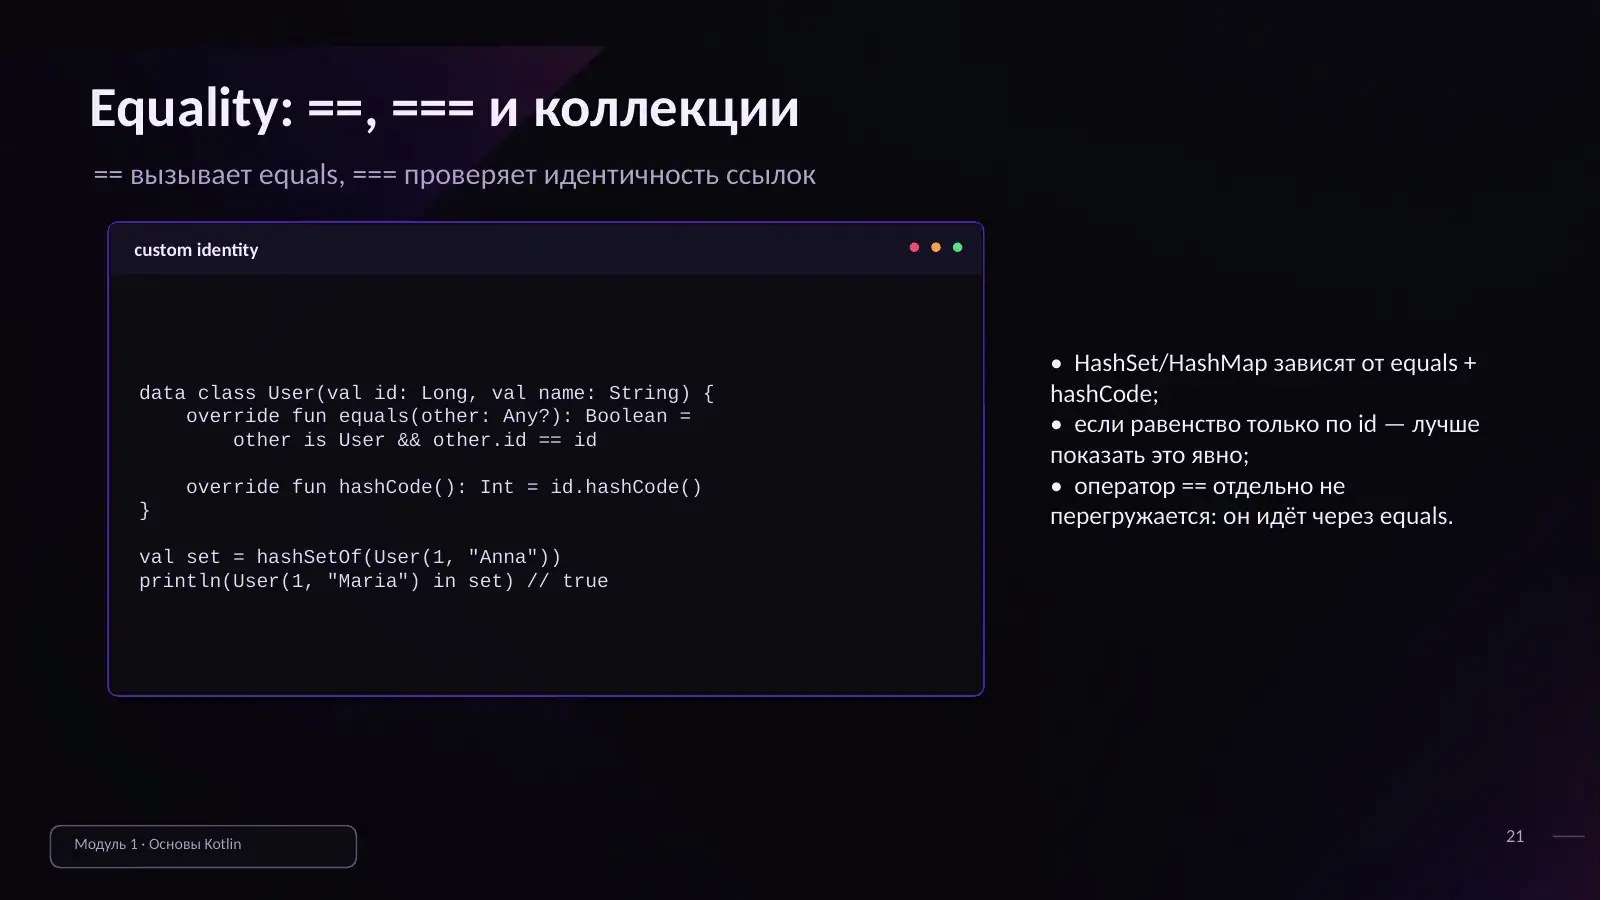
==вызываетequals— как и должно было быть в Java по умолчанию, потому что сравнивать ссылки двойным равно странно;===сравнивает по ссылке. Кроме Kotlin такое встречалось только в JS.
Если переопределить equals, поведение == изменится вместе с ним: внутри он просто вызывает equals.
extension-функции
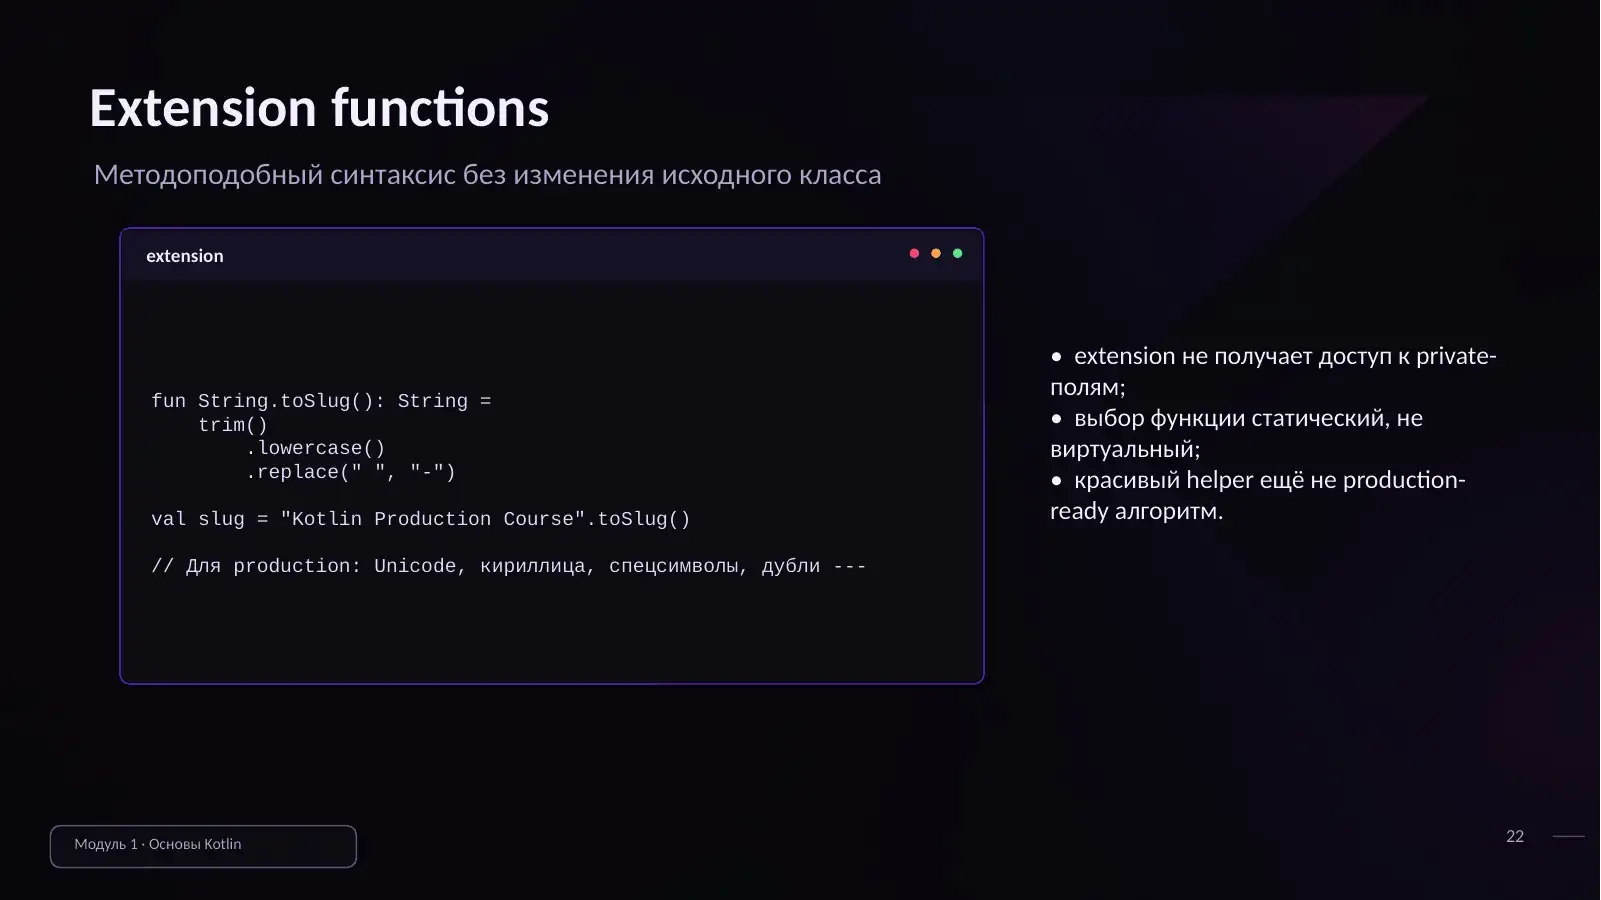
Функция, которую можно дописать вообще к любому классу — и к своему, и к базовому типу:
fun String.toSlug(): String = ...
Важно: такая функция статическая и не имеет доступа к приватным полям класса. Для компилятора это статическая функция.
Используется часто, и в основном под мапперы: toUser, toWhatever.
internal, object, companion
internal — в целом то же самое, что в Java, буквально.
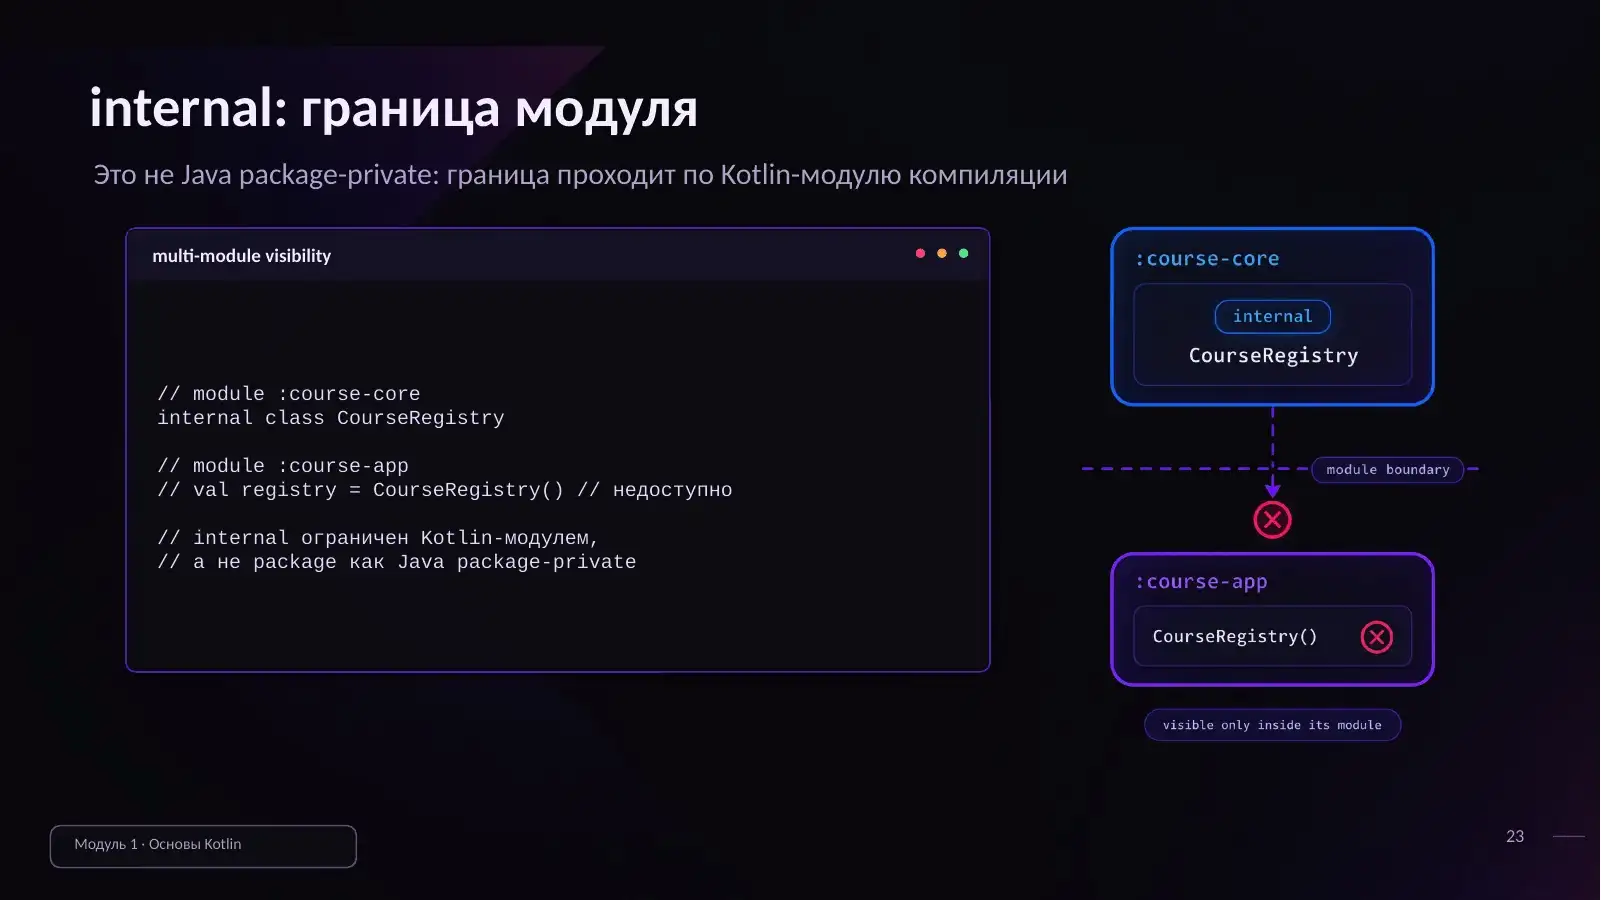
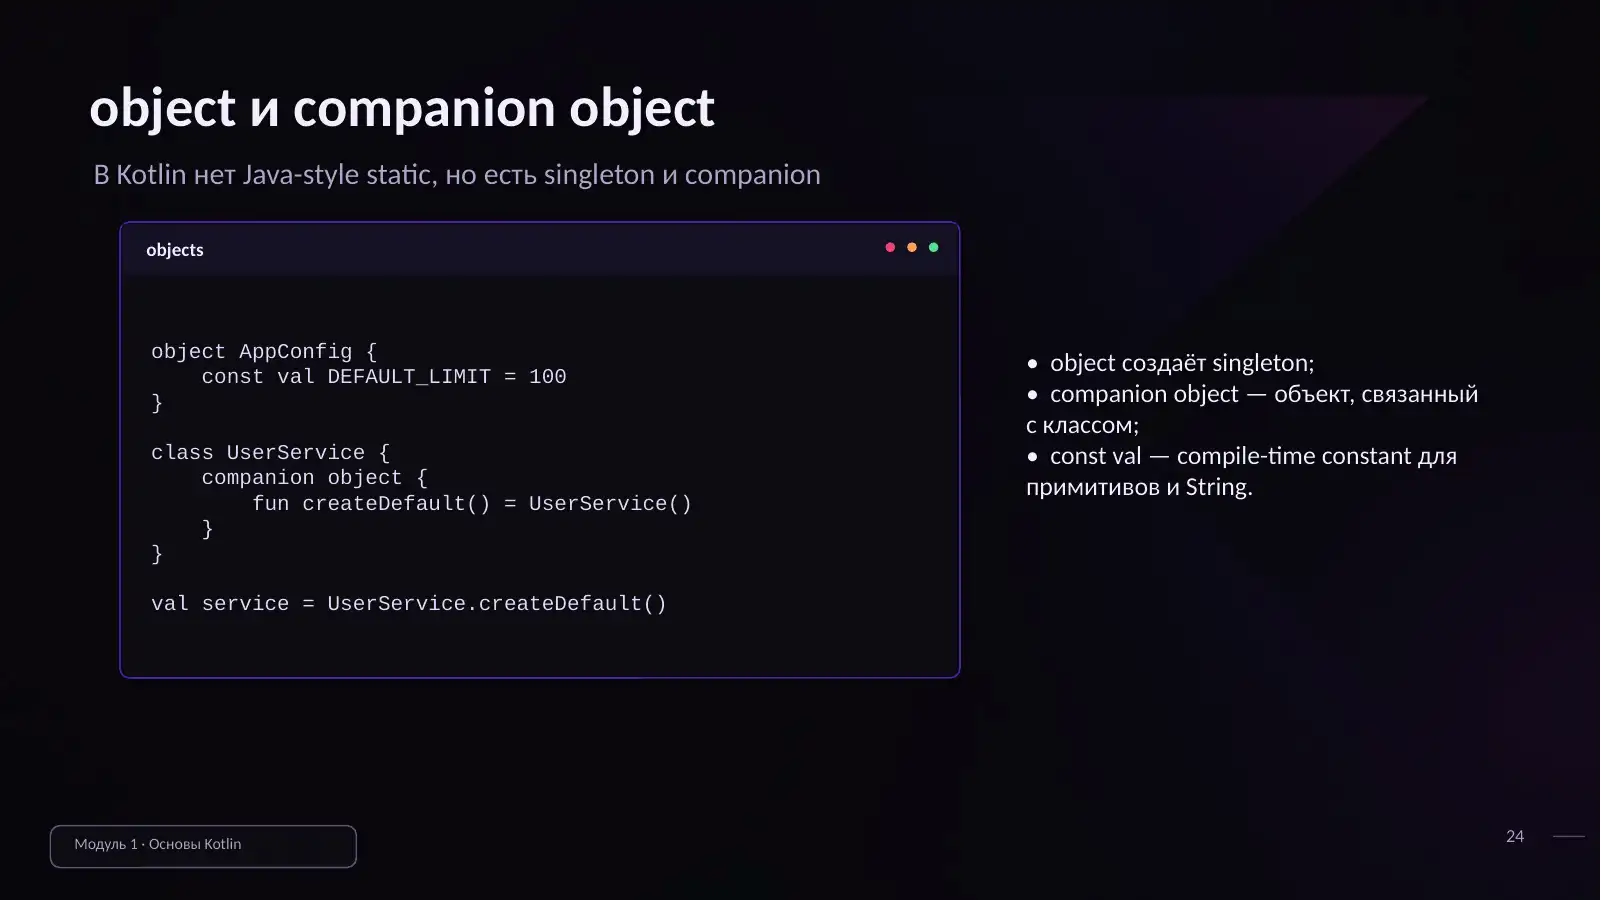
object — то же, что в Java: это синглтон.
Статика в Kotlin отсутствует, поэтому вместо статического блока — companion. Работает он чуть хуже, чем static в Java; как именно — вопрос к Роману Елизарову, который это писал. Когда-нибудь его поймают и спросят.
Лямбды и scope
Внутри лямбды текущий элемент доступен как it, но его можно переименовать — и так обычно и делают, потому что растёт читаемость:
users.map { user -> user.name }
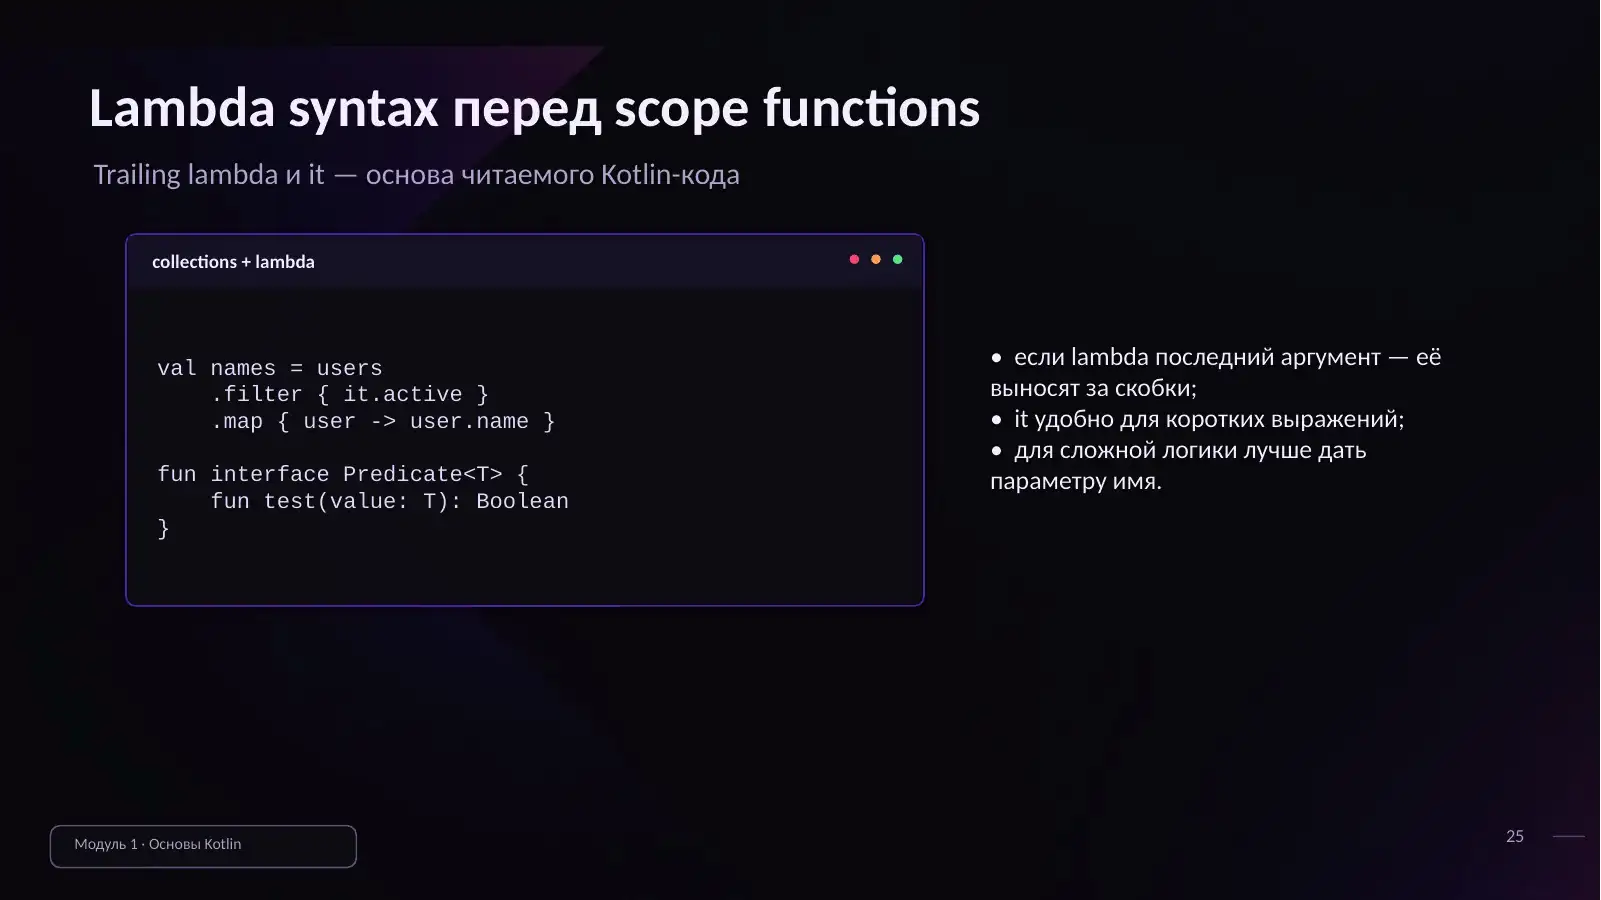
Синтаксис очень похож на Java. Одну и ту же функцию можно писать и как лямбду, и не как лямбду — разницы никакой, это вопрос того, как вам удобнее; лямбды просто чуть веселее.
Небольшая проблема: когда вы заходите в лямбду, меняется scope. Это нужно очень сильно учитывать, особенно когда делаете лямбду в лямбде в лямбде — там будет целых три scope, и между ними можно весело скакать, в том числе брейкать один внутри другого. Похоже на то, как это устроено в плюсах и вообще во всех подобных языках. У filter свой scope, у map уже другой — это две разные лямбды.
Scope-функции
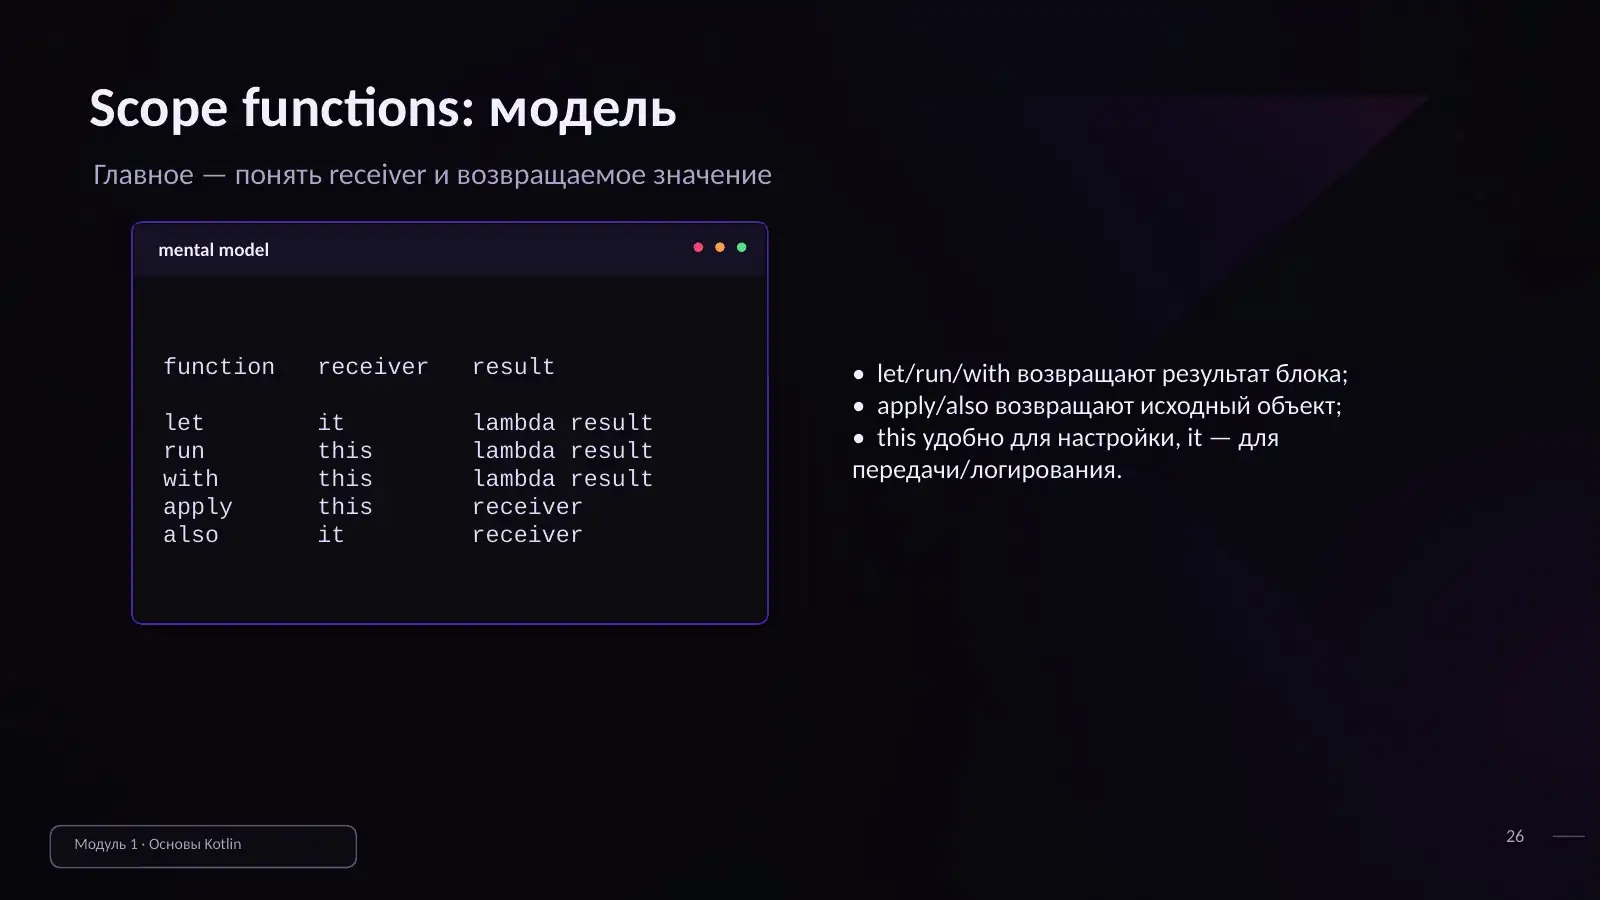
let, run, with, apply, also — все применяются к объекту, но семантически чуть разные:
let,run,withвозвращают новый результат;apply,alsoприменяются к текущему значению и возвращают его же, изменённым.
Самое дефолтное применение let — проверка на null и превращение nullable в не-nullable:
val a = user?.let { it.name }
Вам в функцию пришла nullable-переменная, а работать хочется с обычной — это самый быстрый способ.
apply — заполнить поля объекта или применить к нему какую-то функцию. also — про side-effect’ы: что-то, что не влияет на результат и вообще не связано с классом, например логирование. Отдельная функция под это нужна потому, что применять вы это будете к итерируемым коллекциям: получили что-то из базы, пошли парсить, маппить — и логировать на каждом элементе. run — просто выполнить блок кода, создать лямбду, которая больше ничего не делает.
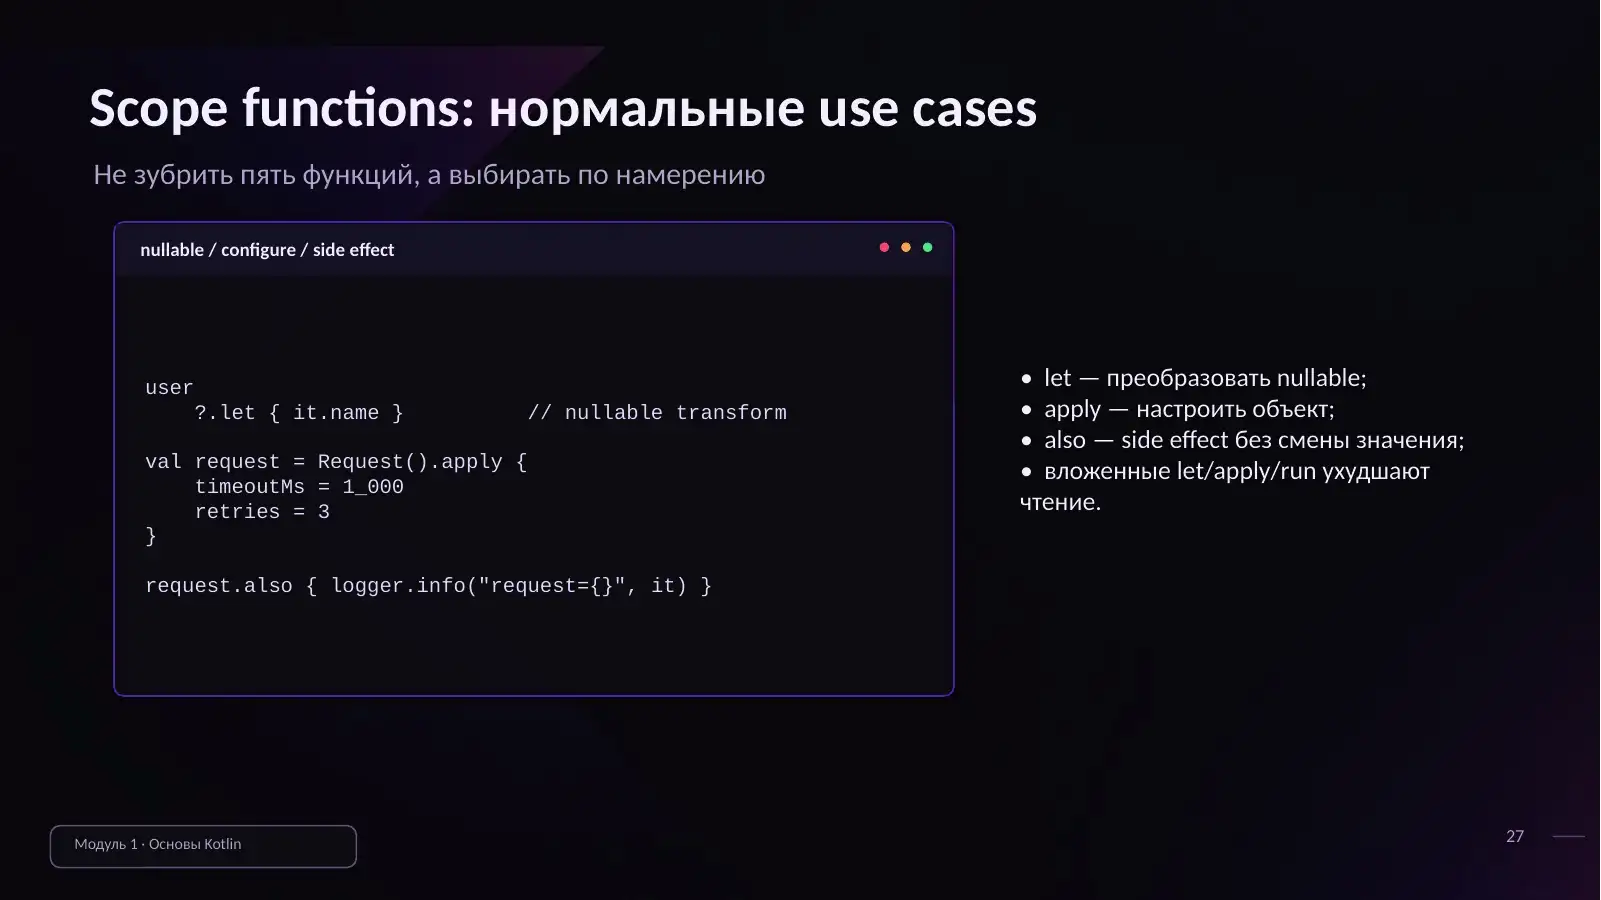
По практике: в основном apply и let, also — один раз, run — не использовался. Это куча сахара, и в коде такие горстки из трёх-четырёх идущих подряд методов видно постоянно — они заменяют примерно вот такой же код на Java. Это удобно, просто нужно уметь читать, а читать относительно просто — если, конечно, не лямбда в лямбде в лямбде.
Дженерики
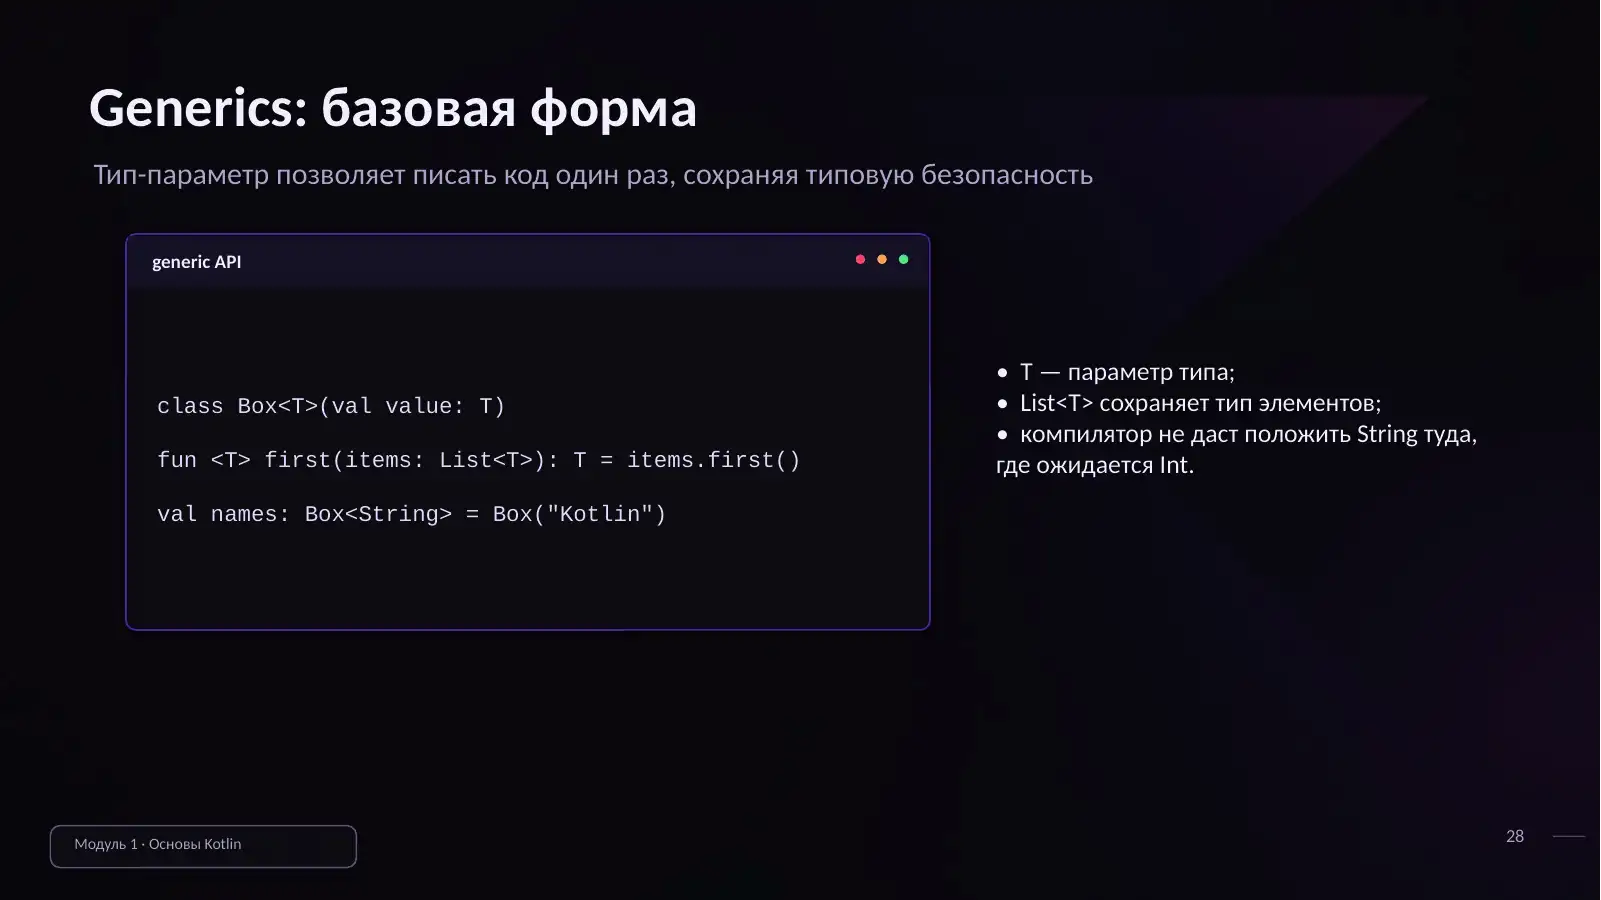
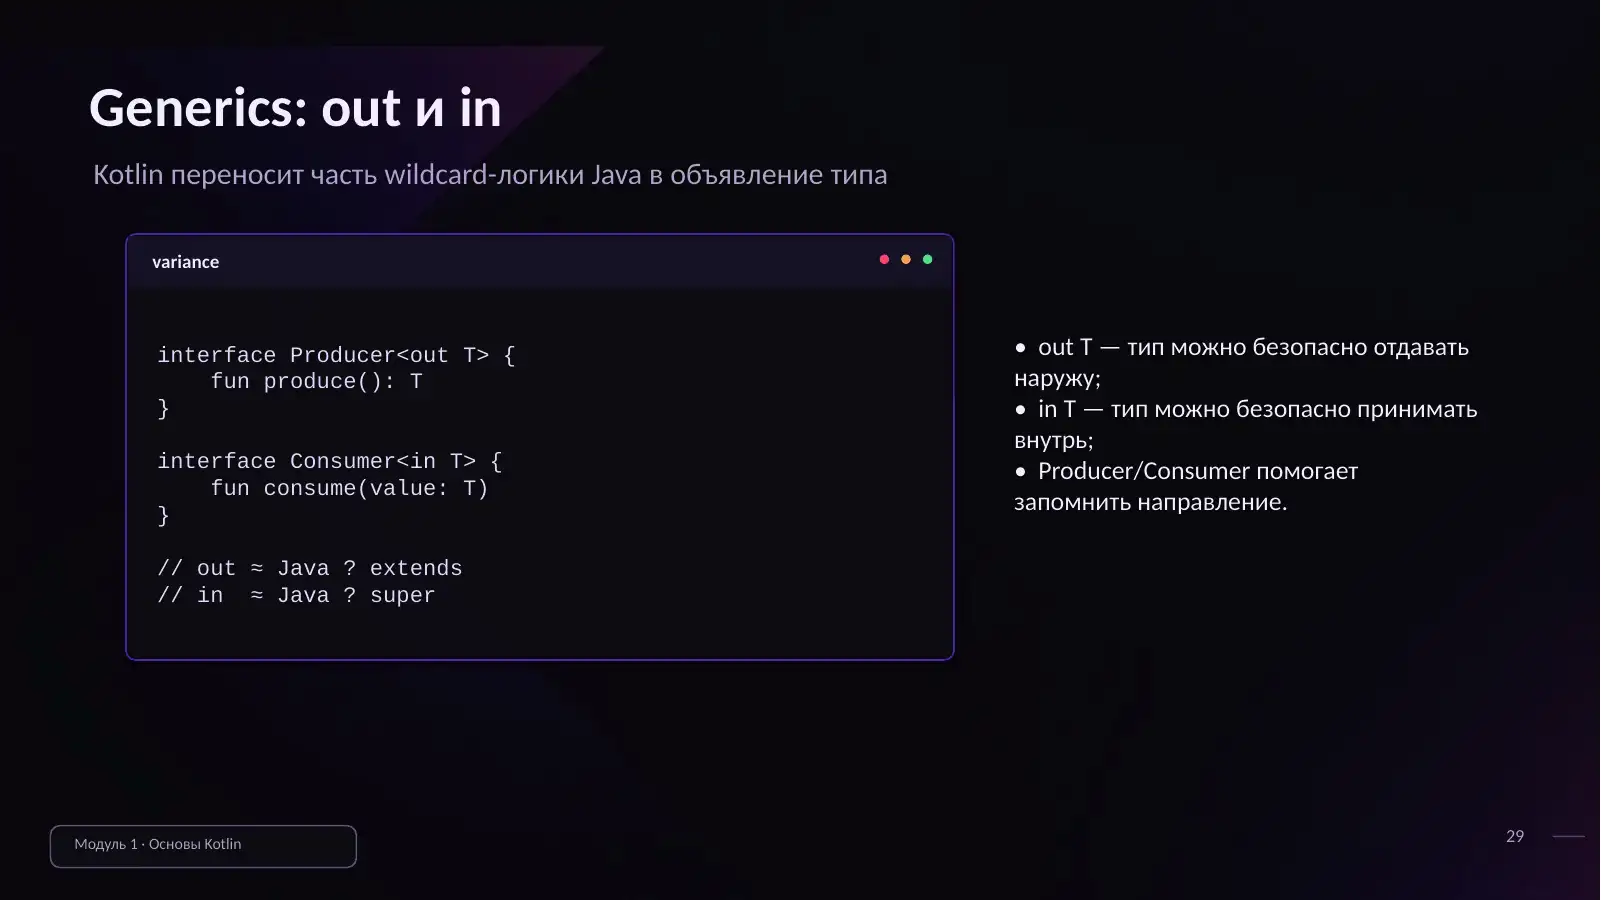
Точно такие же, как в Java. Есть небольшое отличие — generic можно передавать на вход и на выход. Зачем это нужно — вопрос без ответа: ни в рабочем коде, ни в проектах, ни в чужом коде это ни разу не встречалось. Но делать так можно, если очень хочется.
Перегрузка операторов
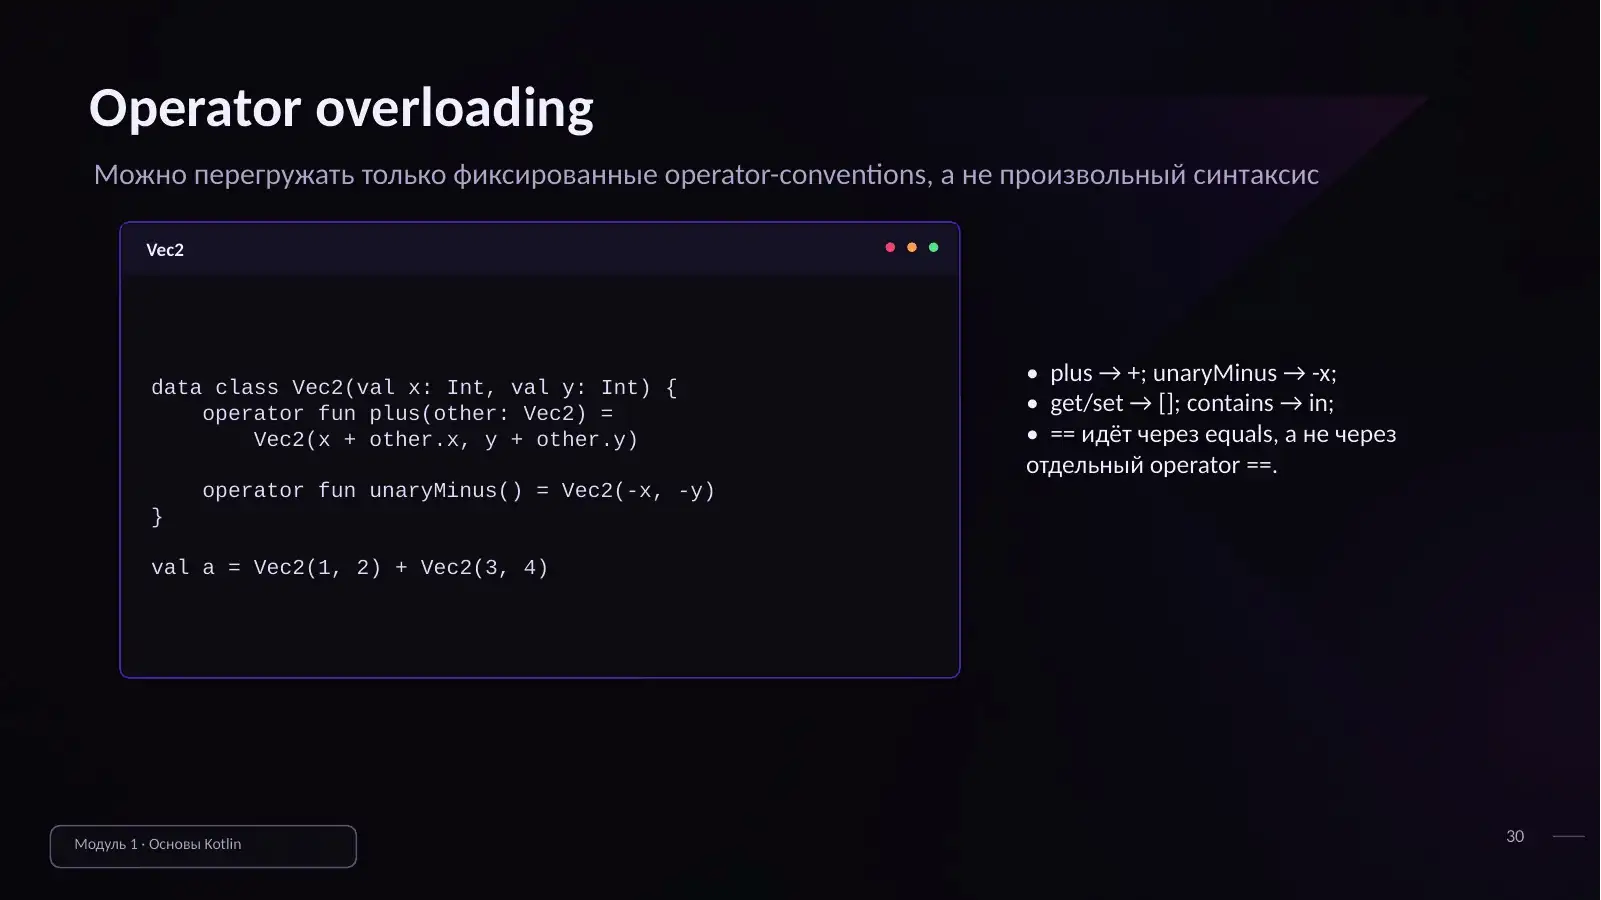
Работает как в плюсах: перегрузить можно любой оператор — только не через символ, а через функцию с определённым именем (plus и так далее). Это тот же неявный вызов функции, просто спрятанный за символом, — как и в Java, где + под капотом был методом. Не перегружается только ===, то есть сравнение по ссылке.
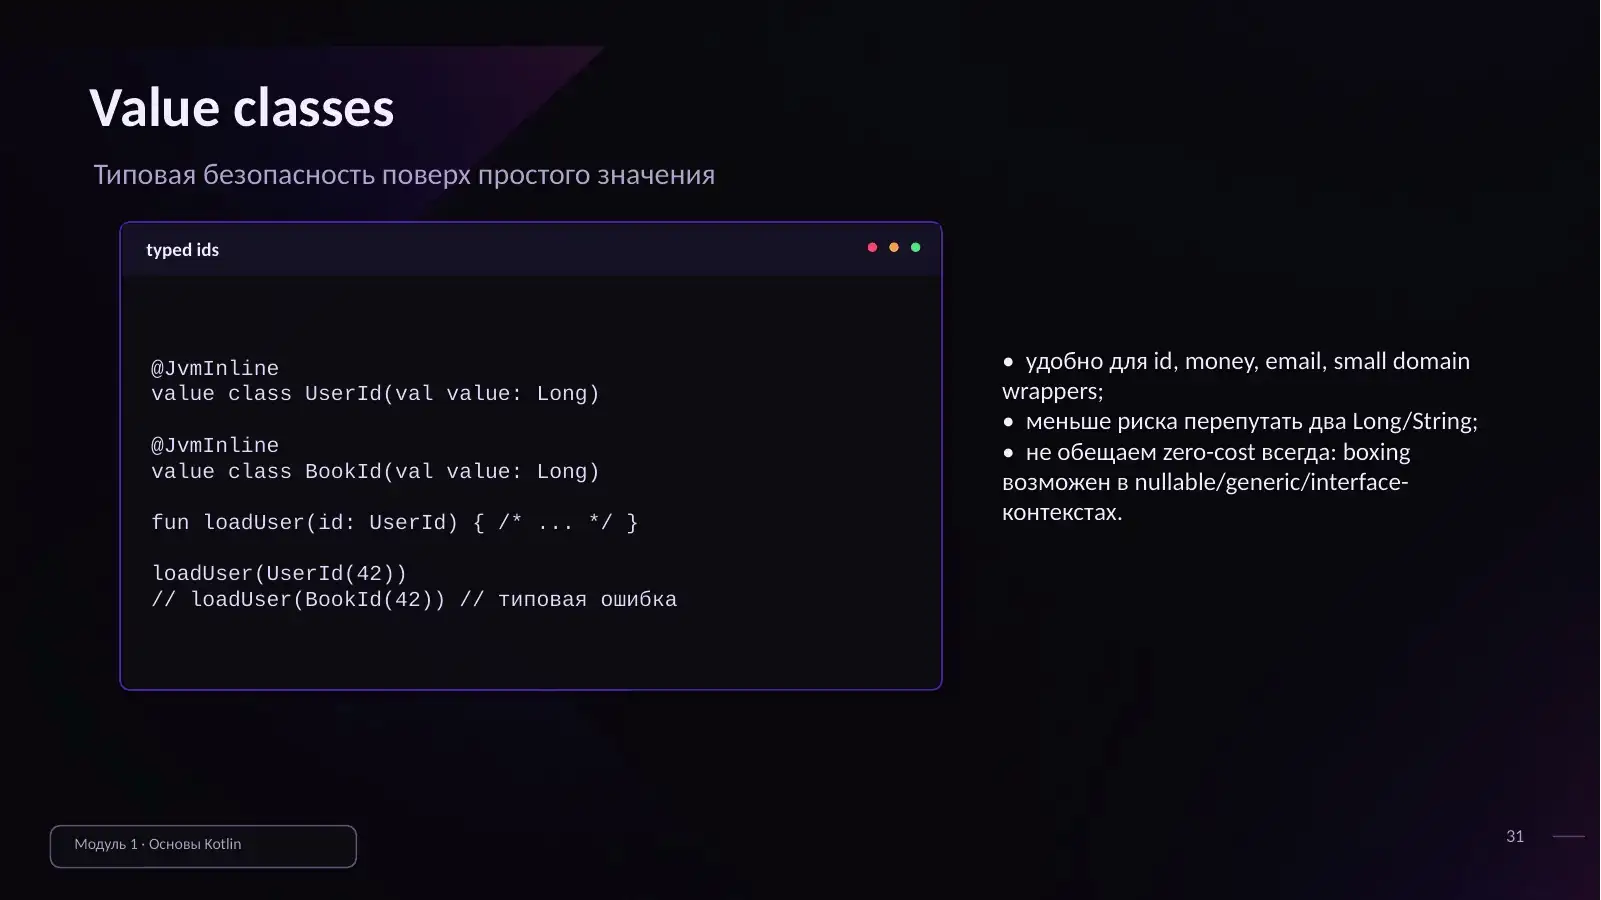
value class
Ещё один семантический сахар, который помогает избежать ошибок. Пусть у вас есть book.id и user.id, и оба Long. Функция принимает просто Long — и тот, кто будет ею пользоваться (например, если вы пишете библиотеку), никак не поймёт, какой именно Long туда передавать.
Решение — value-класс: обёртка над примитивом, которая уменьшает шанс ошибки. Передали UserId туда, где ждут BookId, — получили исключение.