
Устойчивые статистики
Когда данные нужно свернуть в одну цифру, среднее оказывается плохой сводкой при выбросах.
День A: с. День B: с. Среднее в обоих случаях — 6 с.
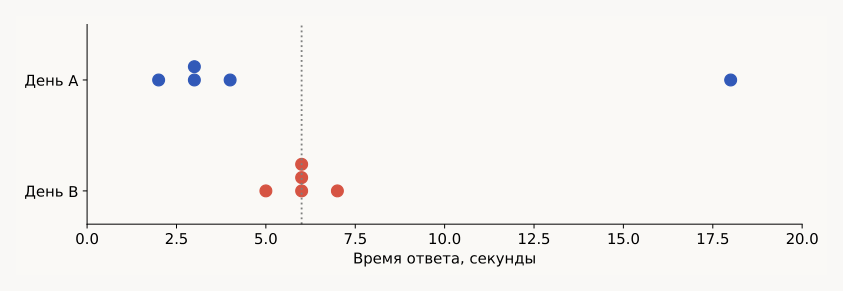
При этом с, с, а разброс отличается на два порядка: , . В день A четыре ответа из пяти укладываются в 2–4 с, и среднее целиком сдвигает единственное значение 18 с.
Отсюда пара устойчивых аналогов:
| Обычная статистика | Устойчивый аналог |
|---|---|
| Среднее | Медиана |
| Дисперсия (СКО) | IQR — межквартильный размах |
Медиана нужна для типичного запроса, среднее — например, для суммарного времени. Использовать будем в основном IQR, потому что выбросы есть везде: даже если удалить текущие, выбросами становятся новые точки распределения.
EDA — обязательный этап перед любой ML-задачей: смотрим, какие данные есть, как они распределены, нужны ли они и не слишком ли они плохие. Общий порядок работы:
- Вопрос и критерий ответа: что хотим узнать и о какой совокупности.
- Данные и их качество: сбор, единица наблюдения, пропуски, ошибки.
- EDA: распределения, группы, связи, необычные наблюдения.
- Подготовка: масштаб признаков и представление данных.
- Проверка: гипотеза и неопределённость либо модель и валидация.
- Вывод: ответ на вопрос, ограничения, следующий шаг.
Масштабирование данных
Зачем оно нужно
Если признаки в разных единицах, расстояние между объектами зависит от этих единиц.
| Объект | Возраст, годы | Доход, тыс. руб. |
|---|---|---|
| A | 20 | 50 |
| B | 30 | 51 |
| C | 21 | 60 |
Здесь . Если записать доход не в тысячах, а в рублях, вклад дохода в квадрат расстояния вырастет в раз. Рассматривать такие столбцы как обычные координаты точки нельзя, поэтому каждый признак нормализуем отдельно.
Три скейлера
| Метод | Формула | Опора |
|---|---|---|
| Min–Max | Минимум и максимум | |
| Standard | Среднее и масштаб | |
| Robust | Медиана и IQR |
Min–Max переводит выборку на отрезок : минимум становится нулём, максимум — единицей. Проблема — выбросы: одно огромное значение прижимает все остальные точки к нулю.
Standard вычитает выборочное среднее и делит на среднеквадратичное отклонение, приводя среднее выборки к нулю, а дисперсию — к единице. Формально стоит брать исправленную дисперсию, но в ML выборки обычно настолько большие, что при исправленная дисперсия сходится к истинной и разница несущественна. Слабое место то же: одно сильное отклонение сдвигает среднее, а на дисперсию выбросы влияют квадратично.
Robust — устойчивый аналог Standard: среднее заменено медианой, СКО — межквартильным размахом. По факту мы отбрасываем хвостовые значения.
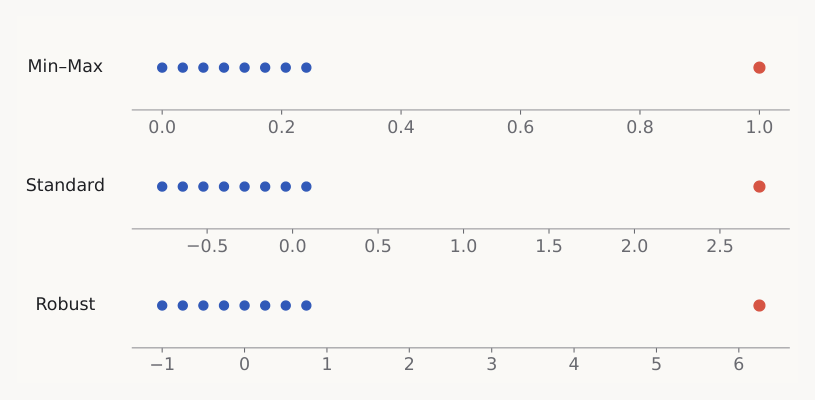
Одни и те же значения . Важно: Robust не удаляет выбросы, красная точка остаётся крайней — он лишь позволяет аккуратнее обработать остальные данные. После Min–Max основная масса ужимается примерно в , после Standard становится чуть шире, после Robust размах основной части — около двойки. Чем ближе точки друг к другу, тем больше точности в расстояниях теряется при работе с числами с плавающей точкой, так что различимый размах — не косметика. Если выброс ничего не значит, его лучше просто удалить.
Что скейлеры не меняют
Форму распределения. Они его только масштабируют.
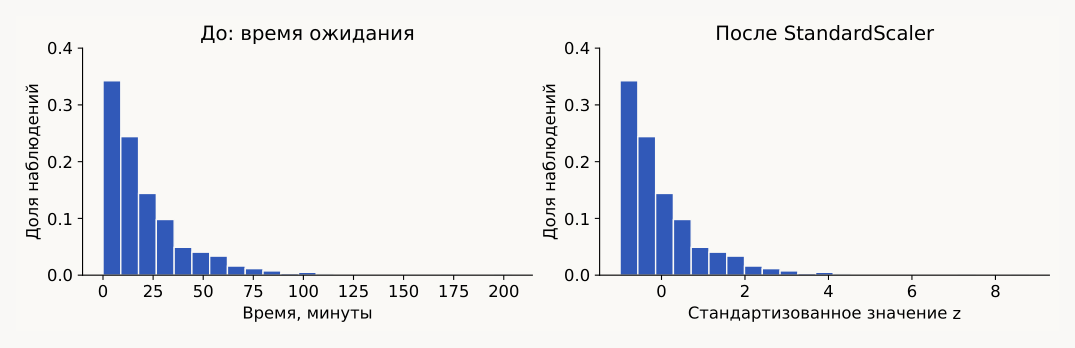
2000 значений из экспоненциального распределения со средним 20 мин: после преобразования , , но правый хвост никуда не делся.
Стандартизация нужна и потому, что расстояния, PCA и регуляризация чувствительны к масштабу, и потому, что в линейных моделях мы рассчитываем на стандартное нормальное распределение ошибок; при слишком широких данных распределение шума перестаёт быть стандартным и приходится дополнительно подгонять коэффициенты.
Параметры считаем по train
Параметры вычисляем по обучающей выборке, отдельно для каждого признака. Нулевой знаменатель требует отдельной обработки.
Пусть на train , . Тогда
Пересчитывать максимум по тесту не нужно и нельзя: это меняет преобразование и раскрывает информацию о тесте — утечка данных, при которой модель фактически выучивает распределение отложенной выборки. Значение за пределами на тесте — нормально и допустимо.
Скейлер — такая же модель, как остальные: у Min–Max обучаемые параметры это минимум и максимум, у Standard — среднее и СКО, а применение сводится к подстановке нового значения в уже обученную формулу.
Накладывать одно масштабирование поверх другого не стоит. Каждый скейлер приводит данные к своему свойству — среднее 0 и дисперсия 1 либо отрезок , — и второе преобразование это свойство ломает, а распределение после двух применений может измениться.
Статистический вывод
Задача
25 запросов: мс, выборочное СКО мс. Прошлый замер давал 37 мс.
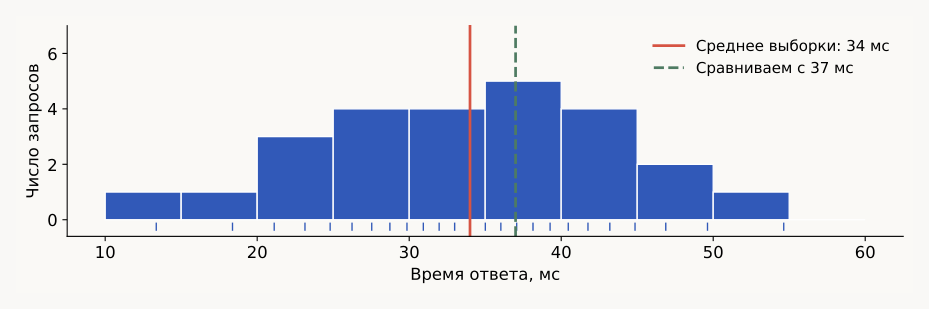
Численно среднее стало меньше, но вопрос в том, отличие это или погрешность. Z-тест простой, однако работает на нормальных или близких к нормальным распределениях, а про время ответа мы этого не знаем. Поэтому берём критерий Стьюдента, который позволяет проверять различие среднего и для ненормальных распределений.
Доверительный интервал
Степеней свободы : одну степень свободы теряем потому, что среднее — это тоже оценка по выборке.
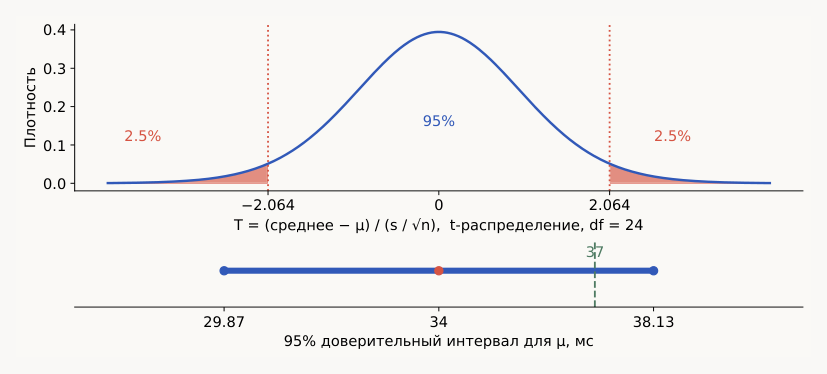
Формулировка «величина попадает в этот интервал с вероятностью 0.95» неверна: величина не случайна, это константа, а интервал посчитан по выборке. Корректно так: при независимых нормальных наблюдениях 95% интервалов, построенных этой процедурой, накрывают .
Значение 37 попадает в интервал — при таком СКО разницу средних можно объяснить случайным отклонением. Нулевую гипотезу мы не отвергаем, а не «доказываем».
Гипотезы и p-value
| Вопрос | Нулевая гипотеза | Альтернатива |
|---|---|---|
| Есть изменение? | ||
| Стало медленнее? |
Статистика критерия измеряет расхождение данных с нулевой моделью, а её распределение при переводит это расхождение в вероятность.
p-value — вероятность того, что при верной статистика окажется настолько же или более экстремальной, чем наблюдаемая. Эмпирически — вероятность попасть в хвосты распределения.
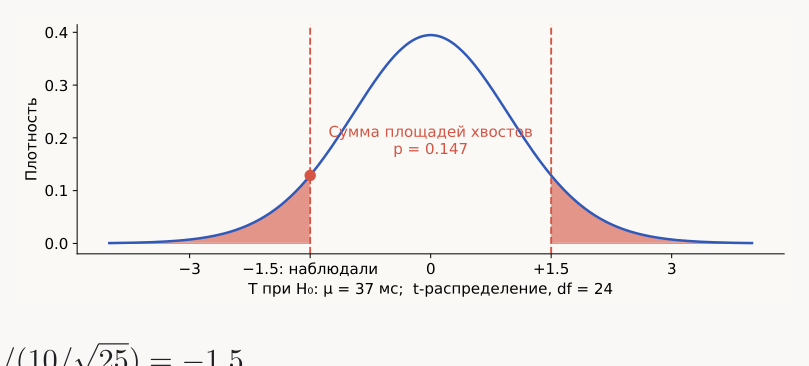
При гипотезу не отвергаем.
Ошибки I и II рода
| Решение | верна | неверна |
|---|---|---|
| Отвергнуть | Ошибка I рода | Обнаружить эффект |
| Не отвергать | Корректное решение | Ошибка II рода |
ограничивает вероятность ошибки I рода. Мощность — вероятность обнаружить заданную альтернативу. Считают её редко, но когда берёте случайный критерий из интернета под свою задачу, сперва прикиньте, как часто он будет давать ошибку второго рода: почти всегда часто.
Критерий хи-квадрат
Честный ли кубик? После 60 независимых бросков частоты граней: 8, 9, 12, 11, 13, 7.
, то есть распределение исходов принадлежит классу дискретных равномерных. Ожидаемая частота каждой грани .
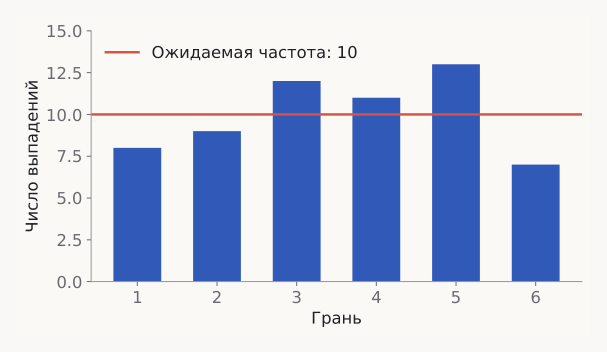
Расхождение наблюдений и ожиданий сворачиваем в одно число:
| Грань | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Наблюдали | 8 | 9 | 12 | 11 | 13 | 7 |
| Ожидали | 10 | 10 | 10 | 10 | 10 | 10 |
| 0.4 | 0.1 | 0.4 | 0.1 | 0.9 | 0.9 |
Простая сумма отклонений равна нулю, поэтому берём квадраты; деление на задаёт масштаб колебаний частот. Хи-квадрат относится к семейству критериев согласия — тех, что проверяют совпадение формы распределения.
Из шести частот одну степень свободы теряем (сумма частот фиксирована и равна 60), остаётся 5. При статистика приближённо имеет распределение .
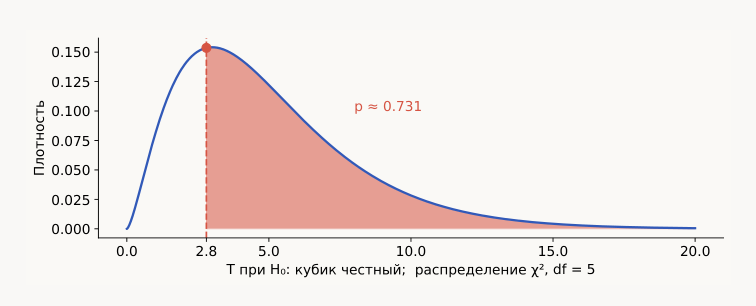
— гипотезу о честном кубике не отвергаем.
Интерпретация p-value
В другом эксперименте получили . Корректный вывод:
Вероятность верности равна 20%— p-value не даёт вероятность гипотезы.- При данных недостаточно, чтобы отвергнуть .
Эффекта точно нет.
В отчёте нужны величина эффекта, интервал неопределённости и условия измерения. Если искать много связей и показывать только значимые, ложные находки накапливаются.
Корреляции
Корреляция — мера зависимости величин, без уточнения, какой именно. Видов её десятки, разбираем два.
Пирсон
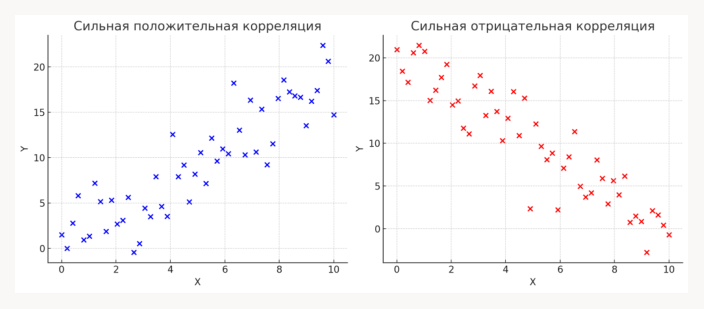
Это мера линейной зависимости, и она же угловой коэффициент линейной регрессии для двух переменных. Маленькое не означает, что зависимости нет.
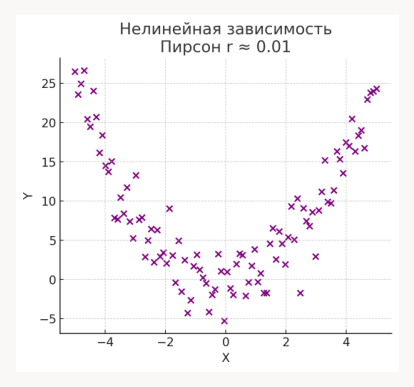
Здесь зависимость очевидно есть, но прямая её не описывает, и Пирсон даёт . Перед выводом по коэффициенту смотрим на форму связи. В тысячемерных данных никаких парабол глазами не увидеть, поэтому одному коэффициенту доверять нельзя.
Спирмен
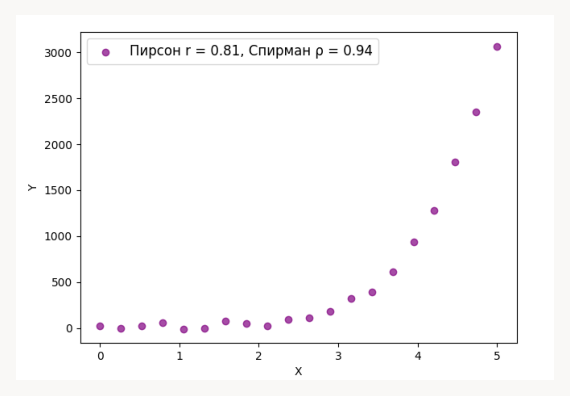
Ранговая корреляция — мера монотонной зависимости: параболу она тоже не покажет, зато монотонная связь может быть нелинейной. При совпадающих значениях используем средние ранги.
Что делаем: сортируем каждую переменную отдельно и нумеруем наблюдения от 1 до .
| Наблюдение | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| Время | 12 | 15 | 17 | 18 | 20 | 21 | 22 | 26 |
| Возраст | 14 | 25 | 20 | 35 | 45 | 30 | 60 | 95 |
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
| 1 | 3 | 2 | 5 | 6 | 4 | 7 | 8 |
Последняя формула применима без совпадающих рангов.
Что делают преобразования признаков
| Преобразование | Pearson | Spearman |
|---|---|---|
| Не изменится | Не изменится | |
| , здесь | Может измениться | Не изменится |
Положительное линейное масштабирование (умножение на константу, сдвиг) сохраняет оба коэффициента. Строго возрастающее преобразование сохраняет ранги, но может изменить линейную форму: куб — тоже монотонное преобразование и ранги не тронет, а вот квадрат при значениях обоих знаков монотонность теряет и ранги поменять уже может.
Отсюда практический приём для параболы с картинки выше: проверять линейную зависимость от корня из (для отрицательных значений — из модуля). После такого преобразования корреляция Пирсона окажется высокой.
Проклятие размерности
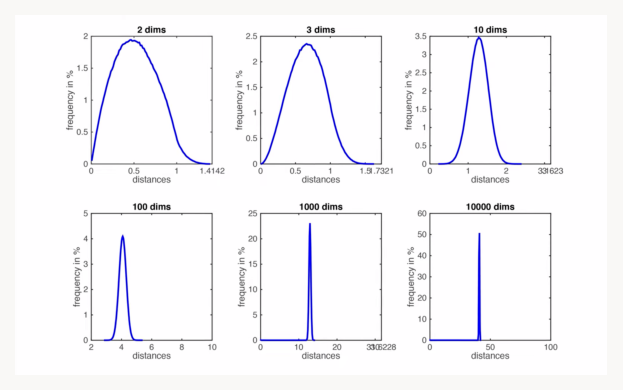
На графиках — распределения попарных расстояний при разном числе признаков. С ростом размерности относительный разброс расстояний уменьшается, «близкий» и «далёкий» соседи становятся менее различимы. Эффект зависит от распределения данных и метрики.
Причина видна из самой формулы: евклидово расстояние — корень из суммы квадратов по всем признакам. Когда слагаемых тысяча, сами расстояния становятся большими и практически одинаковыми, а различия между ними уезжают в мелкие разряды вроде 49.5 и 49.5001 — что вместе с конечной точностью чисел с плавающей точкой окончательно их съедает.
Снижение размерности и PCA
Тысячемерные данные тяжело обрабатывать и невозможно визуализировать. PCA (principal component analysis, анализ главных компонент) борется и с проклятием размерности при огромном числе признаков, и с задачей визуализации сложно устроенных данных.
Пример — шесть образцов и два уровня экспрессии генов (экспрессия — грубо говоря, степень выработки гена).
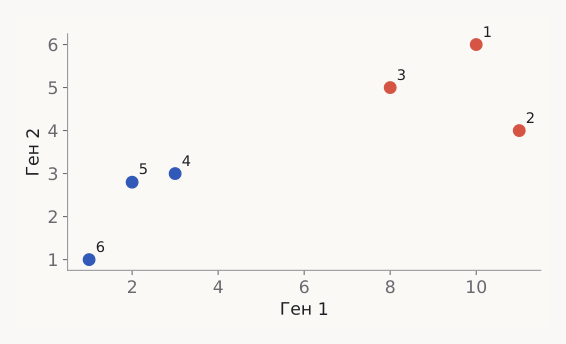
Если оба признака меняются вместе, положение точки можно описывать одной координатой вместо двух. Потеряем при этом часть информации о расстояниях и о том, как именно распределены сами гены.
Шаг 1. Центрирование
Из каждого признака вычитаем его выборочное среднее — сколько бы признаков ни было, центрируем все. Для примера , .
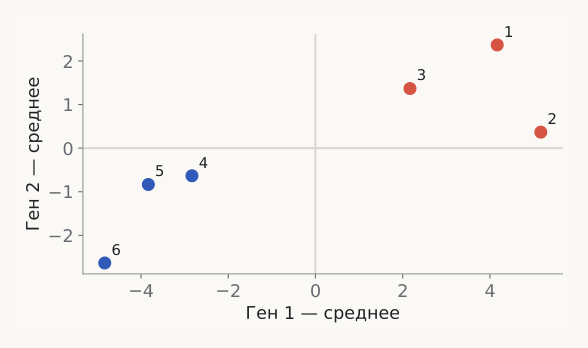
Для образца 1: , . Среднее каждого столбца равно нулю.
Шаг 2. Выбор направления
Строим прямую (в общем случае — гиперплоскость), на которую ортогонально проектируем все точки, и выбираем ту, где разброс координат проекций максимален.
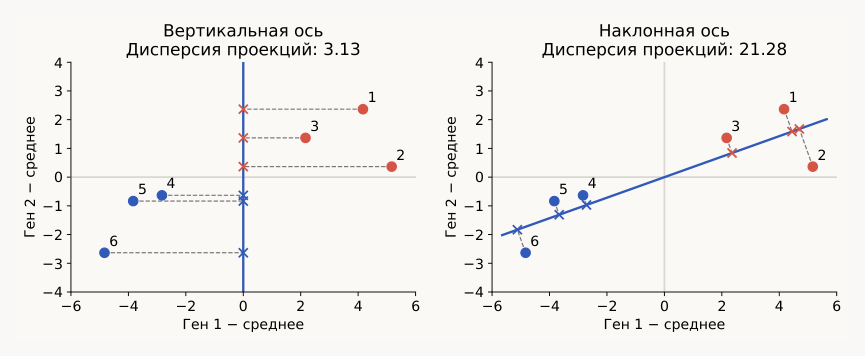
У вертикальной оси дисперсия проекций 3.13, у наклонной — 21.28.
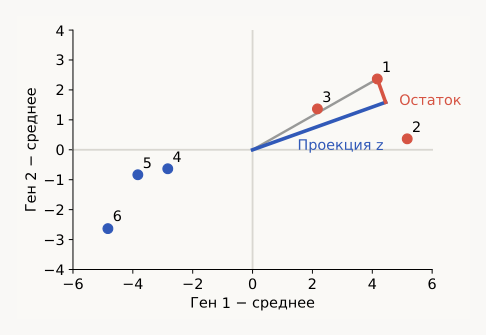
Максимизация дисперсии и минимизация ошибки восстановления — это одно и то же:
где центрированы, — остаток. Сумма фиксирована, поэтому максимизировать значит минимизировать — квадраты перпендикулярных расстояний до оси.
Шаг 3. Следующие компоненты
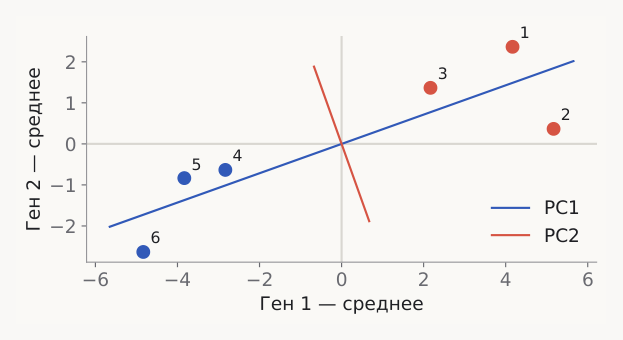
PC1 — направление с наибольшей дисперсией. Дальше остаётся ортогональное ей подпространство размерности , и в нём мы проделываем ровно ту же процедуру: проектируем точки и снова ищем направление максимальной дисперсии. В двух измерениях PC2 просто забирает всю оставшуюся дисперсию. Чем меньше номер компоненты, тем больше дисперсии она объясняет.
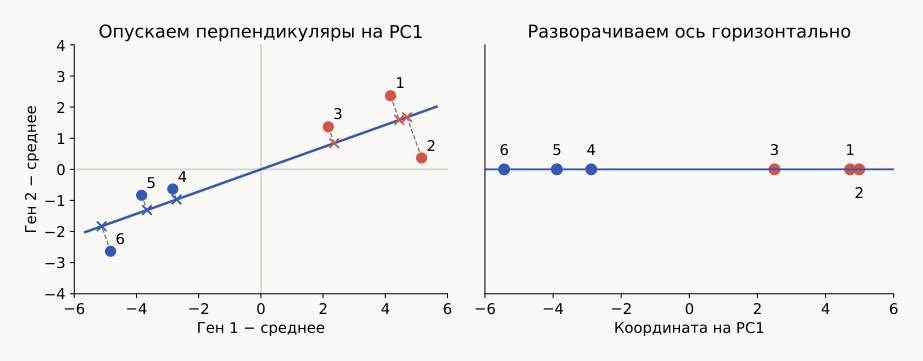
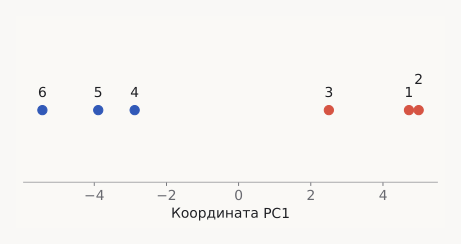
Координата объекта — знаковое расстояние от центра вдоль PC1. Двумерная картинка превратилась в одномерную, распределение расстояний при этом старались сохранить.
Откуда берутся собственные векторы
Для признаков есть попарных ковариаций — таблица :
Для центрированных данных , а дисперсия проекции на направление равна . Ищем единичную ось с максимальной дисперсией проекций, ограничение на длину учитываем множителем Лагранжа:
Получилось уравнение собственного вектора — то есть собственные векторы возникают в PCA не случайно, а всегда, когда речь заходит об ортогональных проекциях и МНК. Собственный вектор — направление, которое оператор оставляет на той же прямой, — во сколько раз он его растягивает. Ковариационная матрица положительно определена: все её собственные числа неотрицательны, а собственные векторы можно выбрать ортонормированными. В точке максимума дисперсия , так что наибольшее собственное число и даёт первую компоненту.
| Компонента | Направление | Дисперсия |
|---|---|---|
| PC1 | ||
| PC2 |
Новая координата — линейная комбинация исходных признаков, то есть вклад каждого исходного гена в компоненту можно посчитать точно:
Для образца 1: . Матрица имеет размер : столько же объектов, меньше координат.
Новый объект преобразуем тем же обученным отображением: для получаем и . Заново обучать PCA не надо — повторный fit создаст другую систему координат.
Объяснённая дисперсия и выбор числа компонент
В нашем примере одна только PC1 объясняет 96.34% общей дисперсии, теряем 3.66% — для большинства задач это незначительно, зато считать теперь нужно вдвое меньше чисел и все алгоритмы работают быстрее.
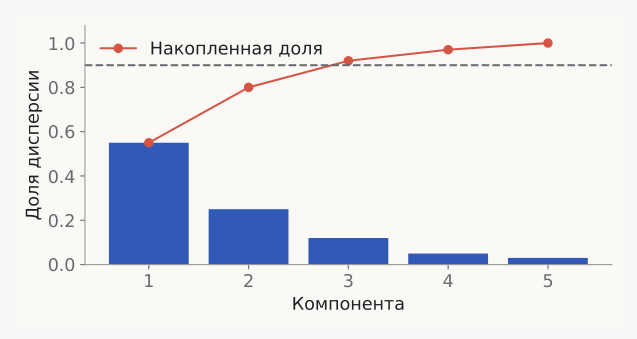
Столбики — дисперсия, объяснённая каждой компонентой по отдельности, линия сверху — накопленная сумма. В условном примере пятимерное пространство разложено на 5 компонент, и для порога 90% хватает (92%). Потерять 10% дисперсии обычно не страшно, потерять 80% — бывает страшно. Для визуализации берут 2–3 оси, для модели проверяют качество на валидации.
Важная оговорка: это доля дисперсии выбранного представления , а не доля сохранённой информации о целевой переменной.
Ограничения
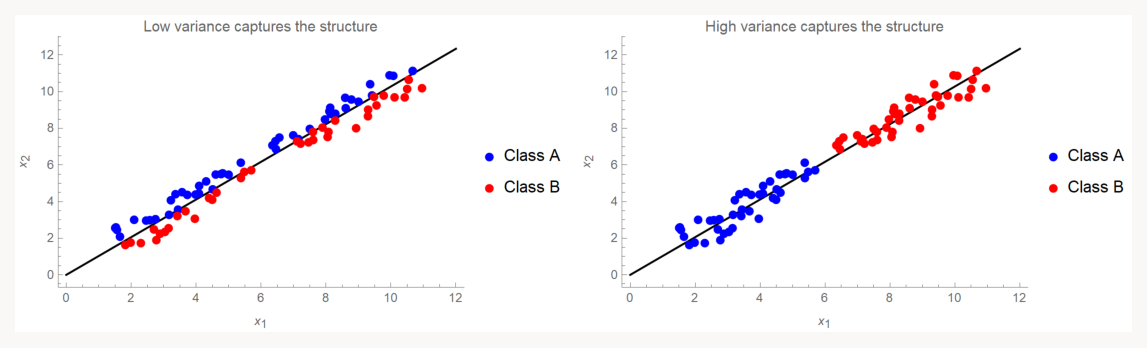
Направление, полезное для разделения классов, может иметь малую дисперсию — PCA не использует и ничего не знает о классах. Если два класса лежат близко и малодисперсионны, разделить их после PCA будет очень сложно.
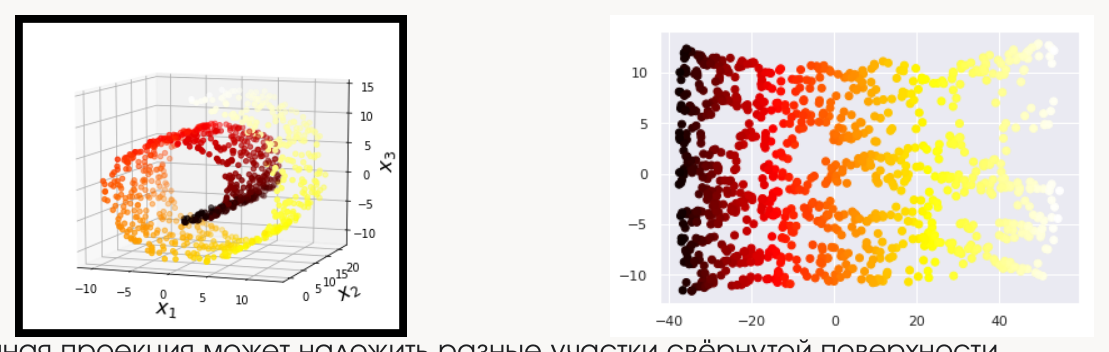
Второе ограничение — линейность. Собственные векторы и ортогональные проекции работают только с линейными преобразованиями, поэтому свёрнутую поверхность (закрученную спираль) линейная проекция накладывает саму на себя, и разные её участки перемешиваются.
Подготовка данных перед PCA
| Шаг | Зачем он нужен |
|---|---|
| Центрирование | PCA описывает отклонения от среднего |
| Масштабирование | Разные единицы меняют ковариации и оси |
| Проверка выбросов | Квадраты отклонений усиливают их влияние |
| Fit на train | Новые объекты используют те же параметры |
При общем осмысленном масштабе может хватить одного центрирования; при разных единицах обычно рассматривают стандартизацию. Руками это всё считать не придётся — на практике всё сводится к fit и последующему преобразованию новых объектов уже обученной моделью.
Обратное преобразование по сохранённым компонентам даёт лишь приближение исходных данных: чем выше объяснённая дисперсия, тем оно точнее, но отброшенные компоненты не восстанавливаются.
t-SNE
Нелинейный метод: умеет обрабатывать нелинейные зависимости внутри данных и проектировать не на прямые.
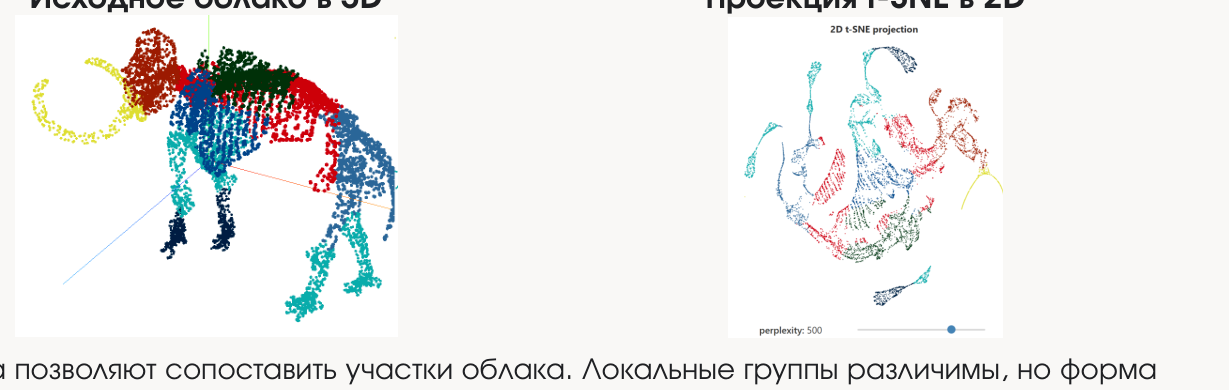
Цвета позволяют сопоставить участки облака: локальные группы различимы, но форма мамонта и глобальные расстояния искажены.
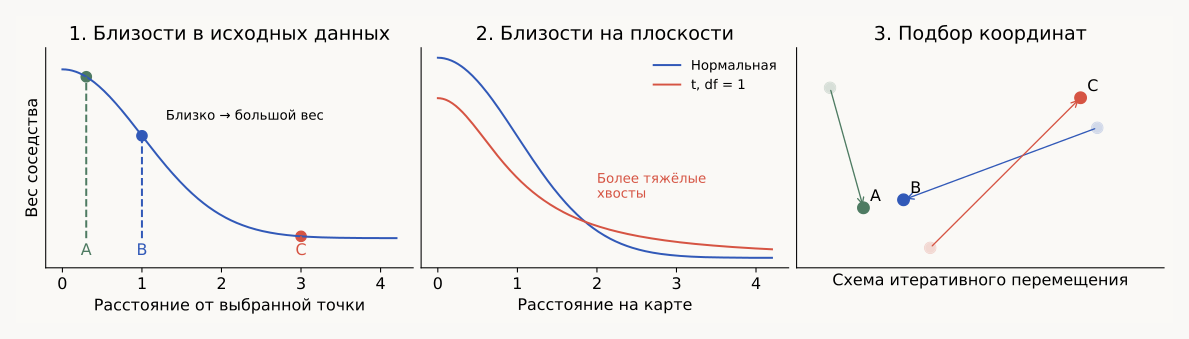
- Из расстояний получаем вероятности соседства .
- На карте считаем близости с тяжёлыми хвостами t-распределения.
- Перемещаем точки, уменьшая расхождение и . Это не сохранение всех расстояний.
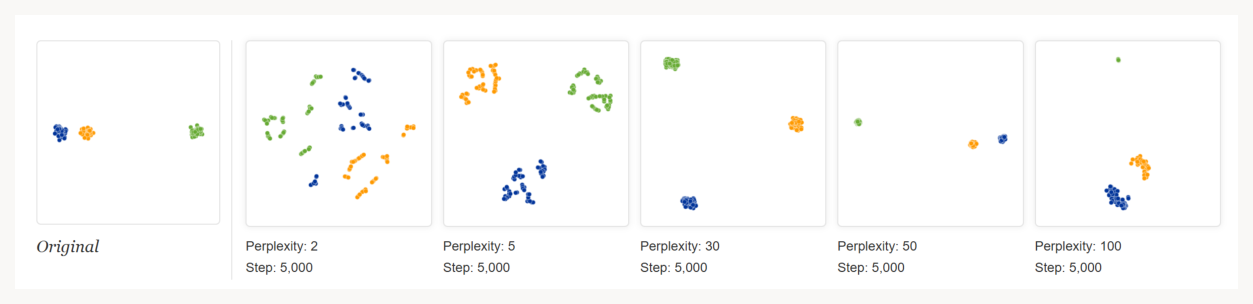
t-SNE адаптирует локальный масштаб, поэтому площади групп и расстояния между ними нельзя напрямую трактовать как исходную геометрию. Для проверки — другие seed и perplexity, исходные признаки и технические партии данных.